0.1 加 0.2 为什么不等于 0.3?IEEE 754 双精度逐位实测

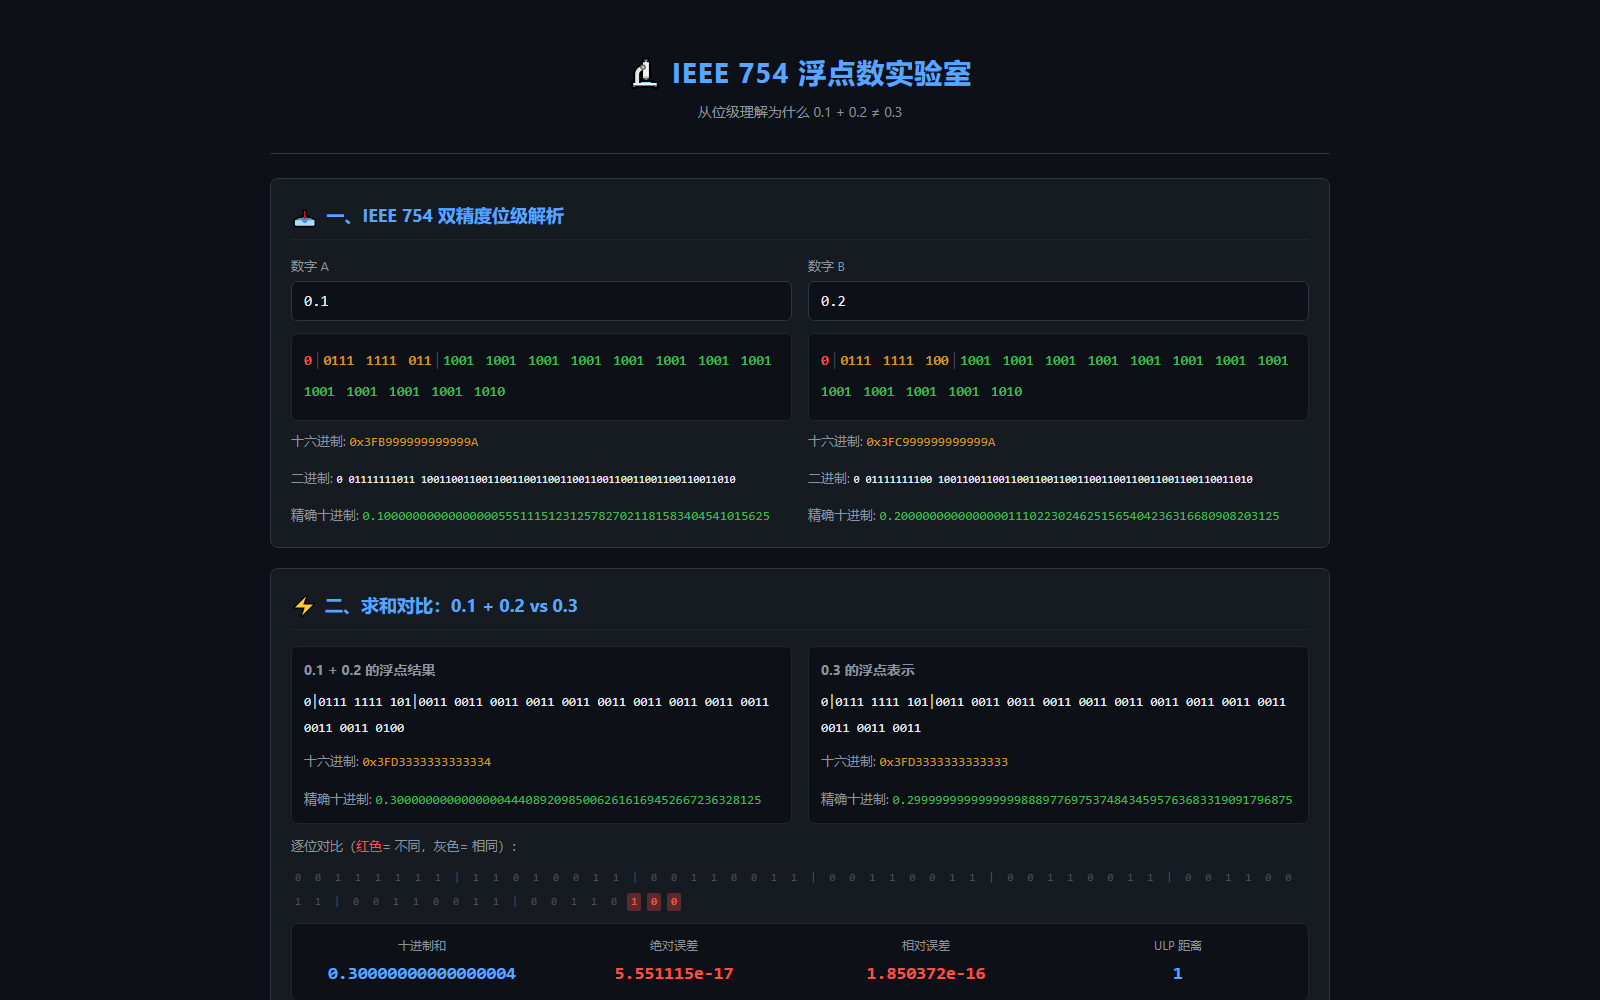
先给结论:0.1 和 0.2 在 double 里本来就存不下,相加之后再舍入一次,结果落到了 0.3 的隔壁。
我把三个数的 64 位都展开对了一遍,0.1 加 0.2 得到 0x3FD3333333333334,写成十进制是 0.30000000000000004。
0.3 自己的位串是 0x3FD3333333333333。
两个 64 位数摆在一起,最低 3 位不同,其余 61 位一模一样,ULP 距离正好是 1,绝对误差 5.551115e-17。
同一份代码里换单精度,0.1 的相对误差是 1.4901e-8;换成双精度,同一个数的相对误差是 5.5510e-17。
前者是后者的 2.68 亿倍,差不多 2 的 28 次方。
这些数字不是我抄的,页面打开时当场算出来。
成品是一个单文件 index.html,双击就能跑,不联网,不引第三方库。
案例目录在这里,下载下来直接打开:
https://atomgit.com/deli007/demo_park/tree/main/codearts-ieee754-explorer
为什么用「逐位拆开」讲这件事
十进制小数在二进制里不是都能除尽的,0.1 换过去是 0.0001100110011…无限循环。
double 只留 52 位尾数,剩下的直接截掉,所以存进去的 0.1 已经不是 0.1 了。
这个道理谁都会说,但说不清到底是哪几位被改了、改完之后差多少。
所以我没写一篇讲解文,而是做了个能输入、能改数、能当场看位串的页面。
它回答三个具体问题:这三个数各自的位串长什么样,相加之后哪几位变了,换成 float32 会差多少。
第一步:把 64 位切成三段看
IEEE 754 双精度按 1 位符号、11 位指数、52 位尾数排列,尾数前面还藏着一个隐含的 1,所以有效精度是 53 位。
我在页面上把这三段用红、黄、绿分色排成一行,每 8 位加一个分隔,避免一眼看过去全是 0 和 1。
0.1 的十六进制是 0x3FB999999999999A。
它实际存下来的值是 0.1000000000000000055511151231257827021181583404541015625。
后面那一长串不是凑数,是这个 double 真正代表的十进制数,逐位展开得到的。
0.2 是 0x3FC999999999999A,精确值 0.200000000000000011102230246251565404236316680908203125。
两个数都往大了偏一点点。
第二步:相加之后,差在最后几位
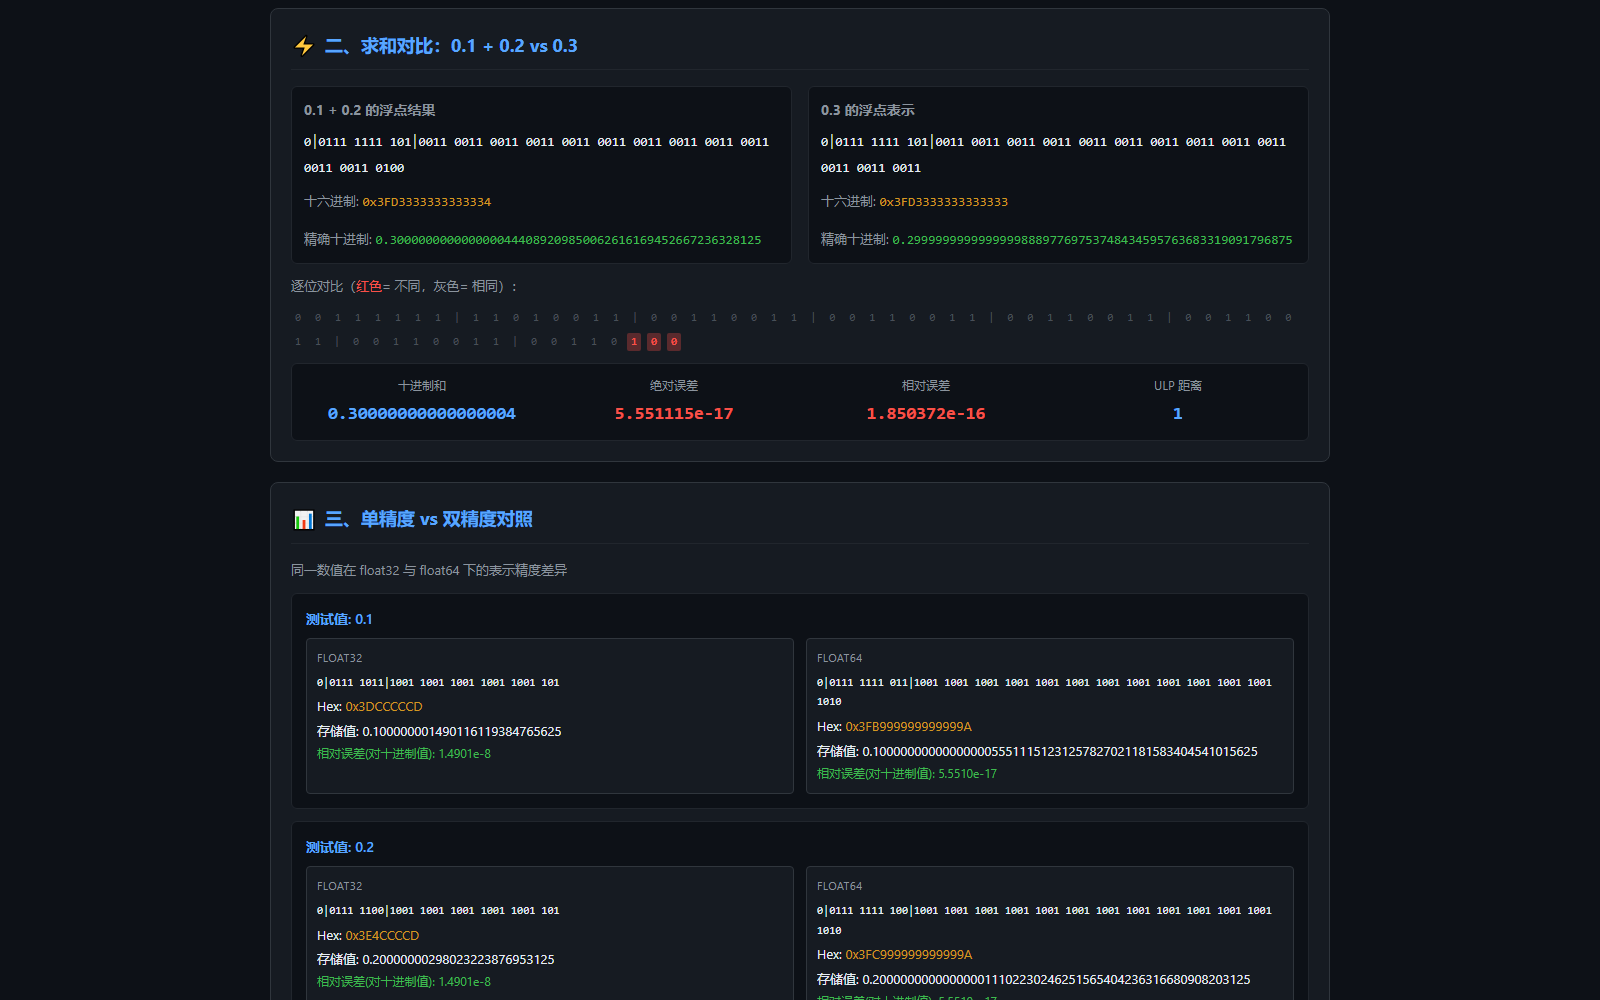
页面把和与 0.3 的位串并排画出来,逐位比对,不同的位标红。
0.1 加 0.2 的结果是 0x3FD3333333333334,精确值 0.3000000000000000444089209850062616169452667236328125。
0.3 是 0x3FD3333333333333,精确值 0.299999999999999988897769753748434595763683319091796875。
| 指标 | 实测值 |
|---|---|
| 十进制和 | 0.30000000000000004 |
| 绝对误差 | 5.551115e-17 |
| 相对误差 | 1.850372e-16 |
| ULP 距离 | 1 |
ULP 是相邻两个 double 之间的间隔,ULP 距离为 1 的意思就是「差了一个最小台阶」。
不是差一点点,是差最小的一格。
第三步:同样的数换成单精度
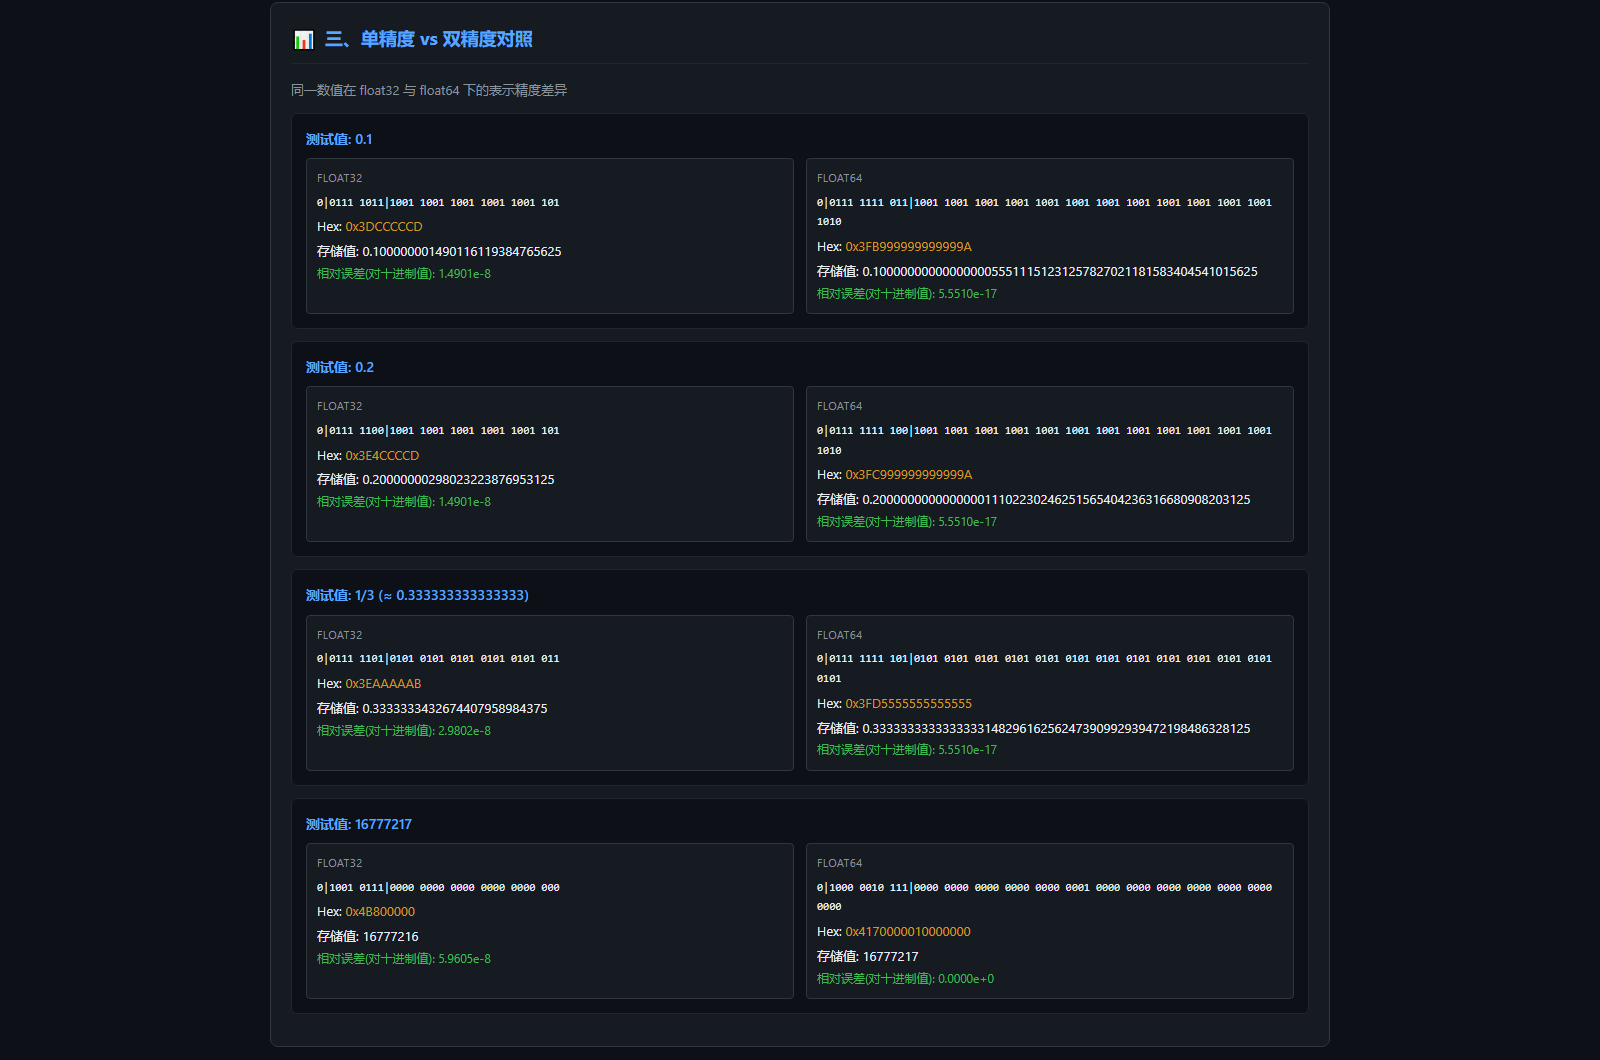
float32 只有 23 位尾数,我拿同一批数在两种精度下各跑了一遍。
| 测试值 | float32 存储值 | float32 相对误差 | float64 相对误差 |
|---|---|---|---|
| 0.1 | 0.100000001490116119384765625 | 1.4901e-8 | 5.5510e-17 |
| 0.2 | 0.20000000298023223876953125 | 1.4901e-8 | 5.5510e-17 |
| 1/3 | 0.3333333432674407958984375 | 2.9802e-8 | 5.5510e-17 |
| 16777217 | 16777216 | 5.9605e-8 | 0.0000e+0 |
最后一行最直观:16777217 在 float32 里直接变成 16777216,整数都能丢。
双精度这边,16777217 能精确表示,误差是 0。
第四步:把 0.1 累加一千次
个位数的误差看着没什么,累加起来就显形了。
页面里用三种方式各算一遍:普通顺序求和、Kahan 补偿求和、BigInt 定点数算出来的精确值。
| 累加次数 | 普通求和 | Kahan 求和 | 精确值 | 普通误差 | Kahan 误差 |
|---|---|---|---|---|---|
| 10 | 0.9999999999999999 | 1 | 1 | 1.110223e-16 | 0 |
| 100 | 9.99999999999998 | 10 | 10 | 1.953993e-14 | 0 |
| 1000 | 99.9999999999986 | 100 | 100 | 1.406875e-12 | 0 |
累加 10 次就差一个 1.11e-16,1000 次差到 1.4e-12。
Kahan 的做法是每次加法都留一个补偿量,把低位丢掉的误差记下来,加到下一次运算里,所以三种规模都是 0 误差。
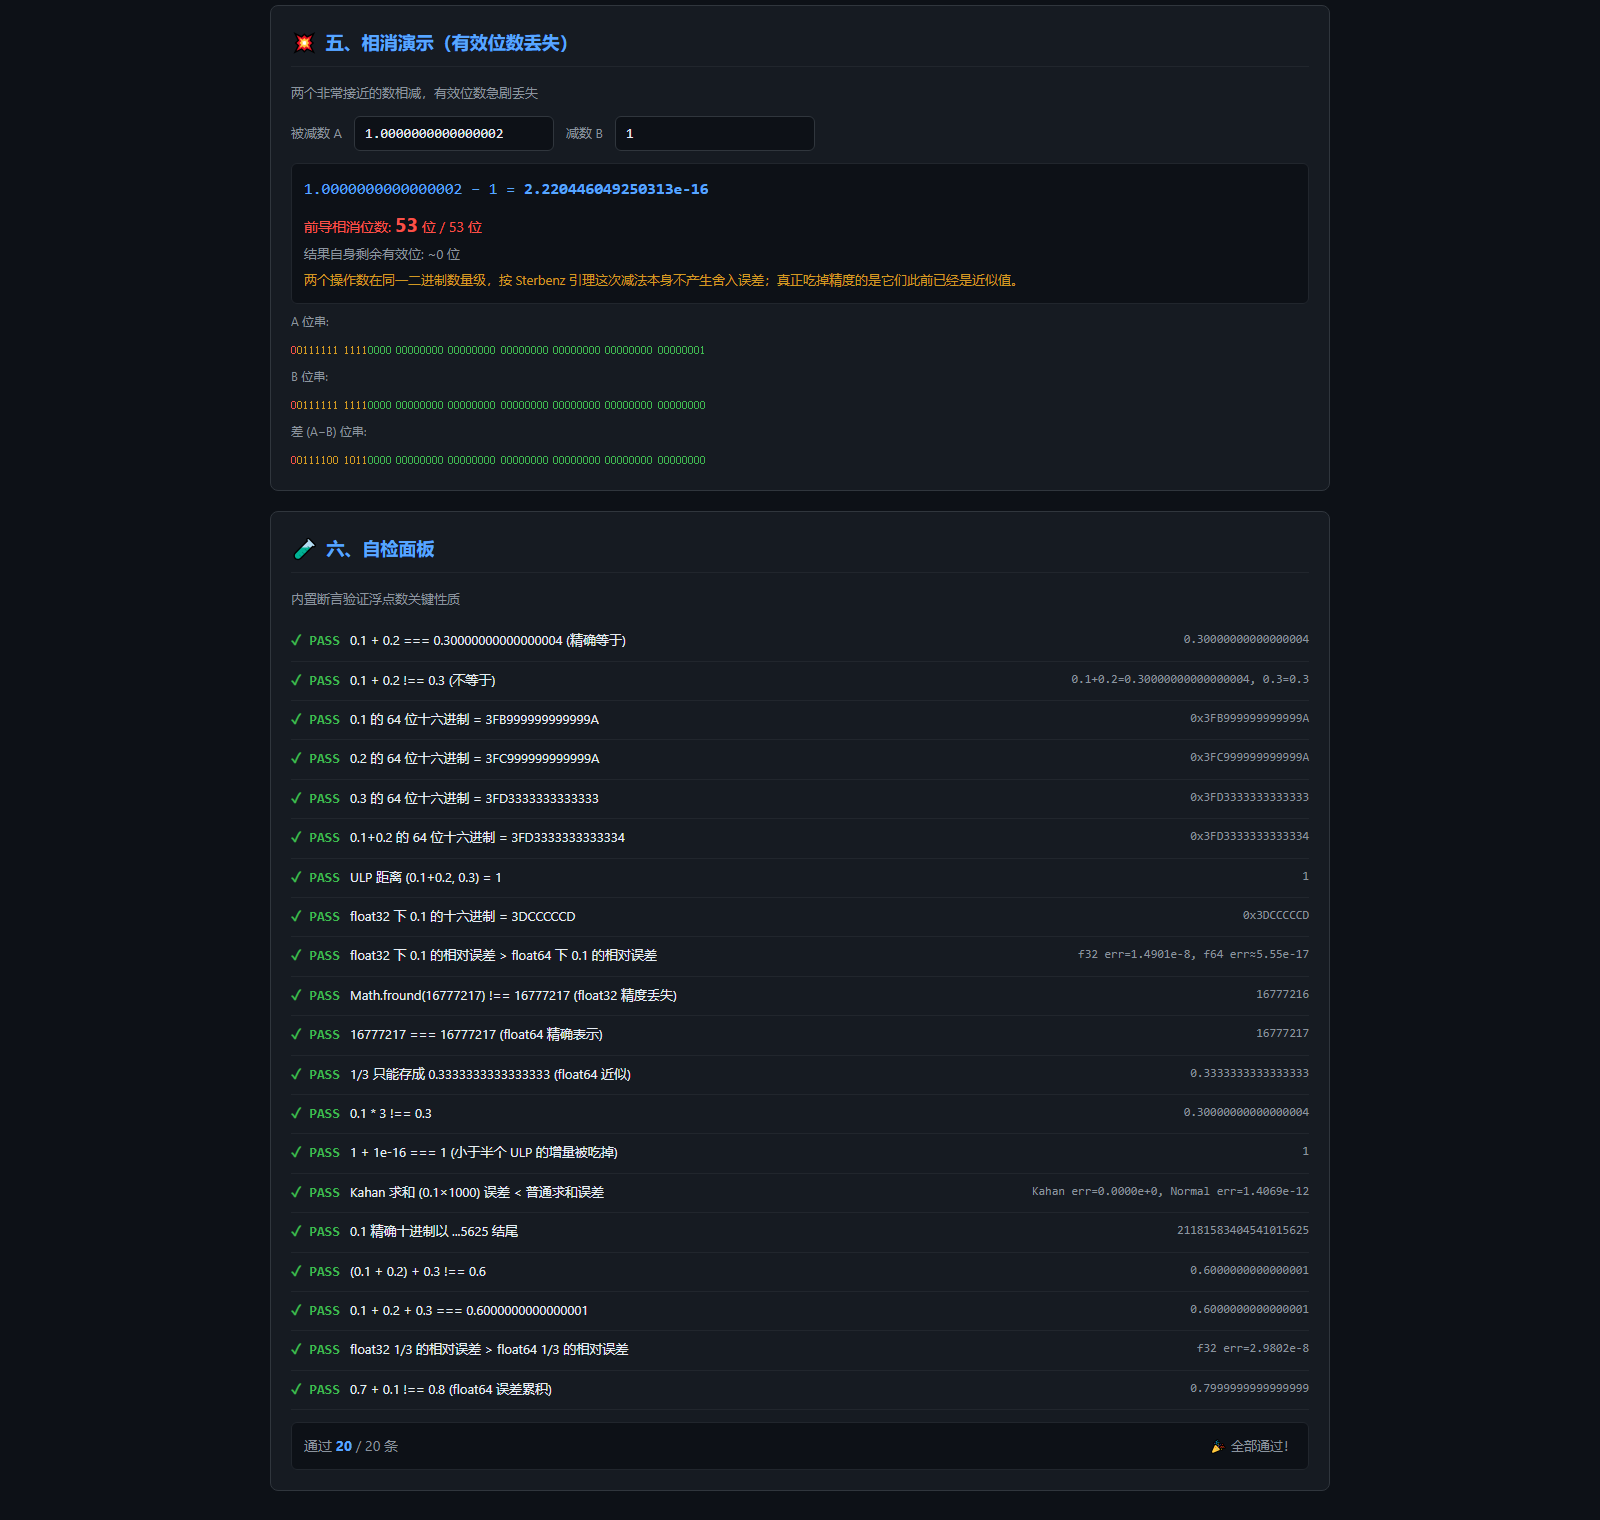
相消演示:这次减法其实是精确的
页面上还留了一个相消演示区,默认拿 1.0000000000000002 减 1。
差是 2.220446049250313e-16,前导相消 53 位。
第一版这里写的是「丢失有效位 53 位 / 53 位」,我后来把这句话改了。
因为这两个数落在同一个二进制数量级,按 Sterbenz 引理,它们的减法本身不产生舍入误差,结果就是精确的。
真正吃掉精度的是它们此前已经是近似值。
现在页面上两句话都写着,读者不用猜。
验证与踩坑:20 条断言,我改掉的 5 处
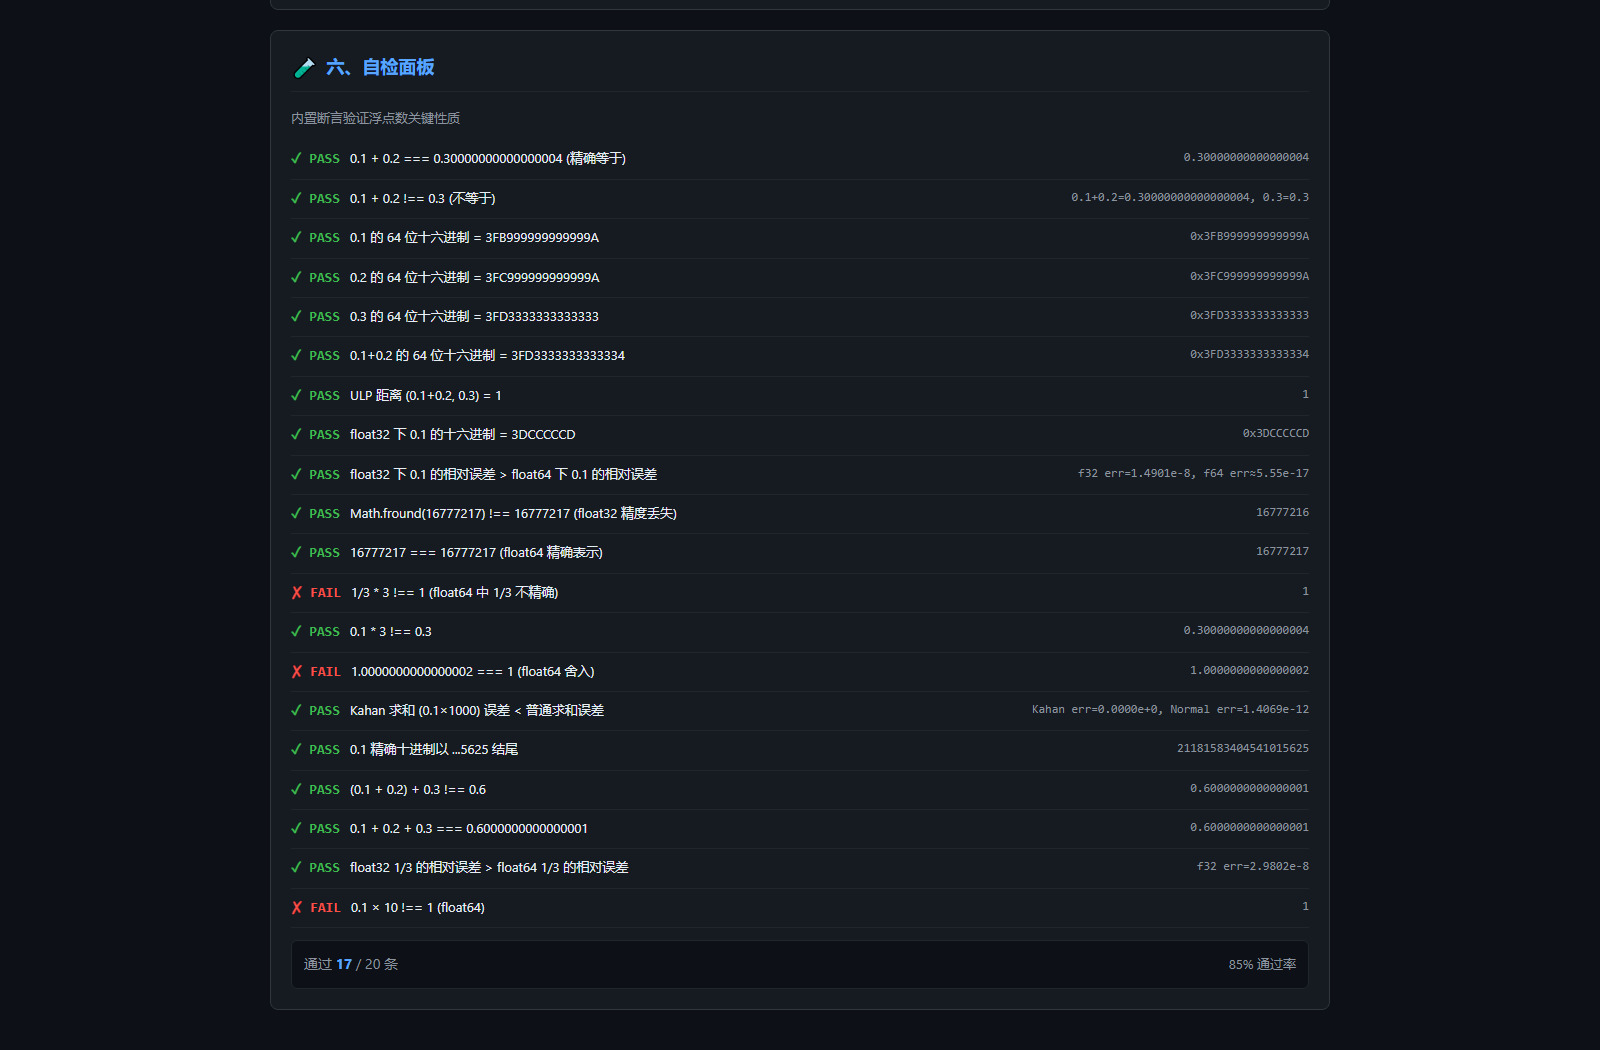
页面底部的自检会把 20 条断言真跑一遍,逐条给出实测值和结论,最后统计通过条数。
改之前是 17/20,这就是下面这张失败路径截图里的现场。
第一处到第三处:有三条断言本身就是假的。
第一条写「1/3 乘 3 不等于 1」,实测等于 1,两次舍入刚好互相抵消。
第二条写「1.0000000000000002 等于 1」,这两个数本来就不同,断言的方向写反了。
第三条写「0.1 乘 10 不等于 1」,实测就是 1。
我把这三条换成真能测的:1/3 只能存成 0.3333333333333333;1 加上 1e-16 会被舍入吃掉,结果还是 1;0.7 加 0.1 等于 0.7999999999999999。
第四处:对照表里 float64 那一列的相对误差恒为 0。
原因是代码拿这个数跟它自己比,当然永远是 0。
这种 0 看起来像「双精度没有误差」,会误导人。
我改成统一跟十进制值算相对误差,0.1、0.2、1/3 三行才显示出真实的 5.5510e-17。
第五处:相消区把一次精确的减法说成丢了 53 位有效位。
修完之后的对照是:修之前 17/20,修之后 20/20 通过,刷新两遍结果一致。
本地复现
把案例目录下载下来,随便起一个静态服务就行:
cd codearts-ieee754-explorer
python -m http.server 8000
然后浏览器打开 http://localhost:8000/index.html 就能看到跟截图一样的页面。
不起服务直接双击 index.html 也可以。
想看修复前的样子,把自检脚本里那三条断言改回去,面板上就会有三条红的。
准备环境:打开码道 Web 版
浏览器打开码道 Web 版:https://devcloud.cn-north-4.huaweicloud.com/chat?source=dmzntgwsf&sourcead=dmzntgwwbwz
登录后在对话框里把需求说清楚就行,不用装软件。
码道有三种使用方式:WebUI(浏览器对话)、TUI(终端命令行)和桌面 IDE(IDE 插件),本文用的是 WebUI。
用码道做这个页面的一点体会
我把需求一次说完:位串分色、求和对比、单精度对照表、累加实验、相消演示,再加一个自检面板。
它一次就给了一个单文件的完整页面,接的是内置预览,跑起来就能点。
但「能跑」和「对」是两件事。
20 条断言里有 3 条是我自己写的期望值写错了,另外 2 处是对照表和相消区的结论不对。
这 5 处没有一处是读代码读出来的,全靠把自检真跑一遍、再拿别的工具对了一遍数。
我自己的结论只有一句:让 AI 写代码,验收这一半得自己扛。
边界,我写清楚
第一个边界:断言里的期望值是我写的,它只能证明代码算出了我预期的东西,证明不了我的预期一定对。
上述 3 条翻车的断言就是例子。
第二个边界:页面用的是浏览器自带的 double,也就是 IEEE 754 binary64,跟语言实现无关,但跟硬件无关这件事我没法在这个页面上验证。
第三个边界:相消区的「前导相消位数」是个按量级估出来的值,它告诉你有效位被挤掉了多少,不等于结果一定不准。

- 点赞
- 收藏
- 关注作者
评论(0)