文件后缀能骗人:8个字节MIME实测看穿真实类型

把一张 PNG 改名成 .jpg,文件名、图标、右键属性都能跟着变,内容不会变。
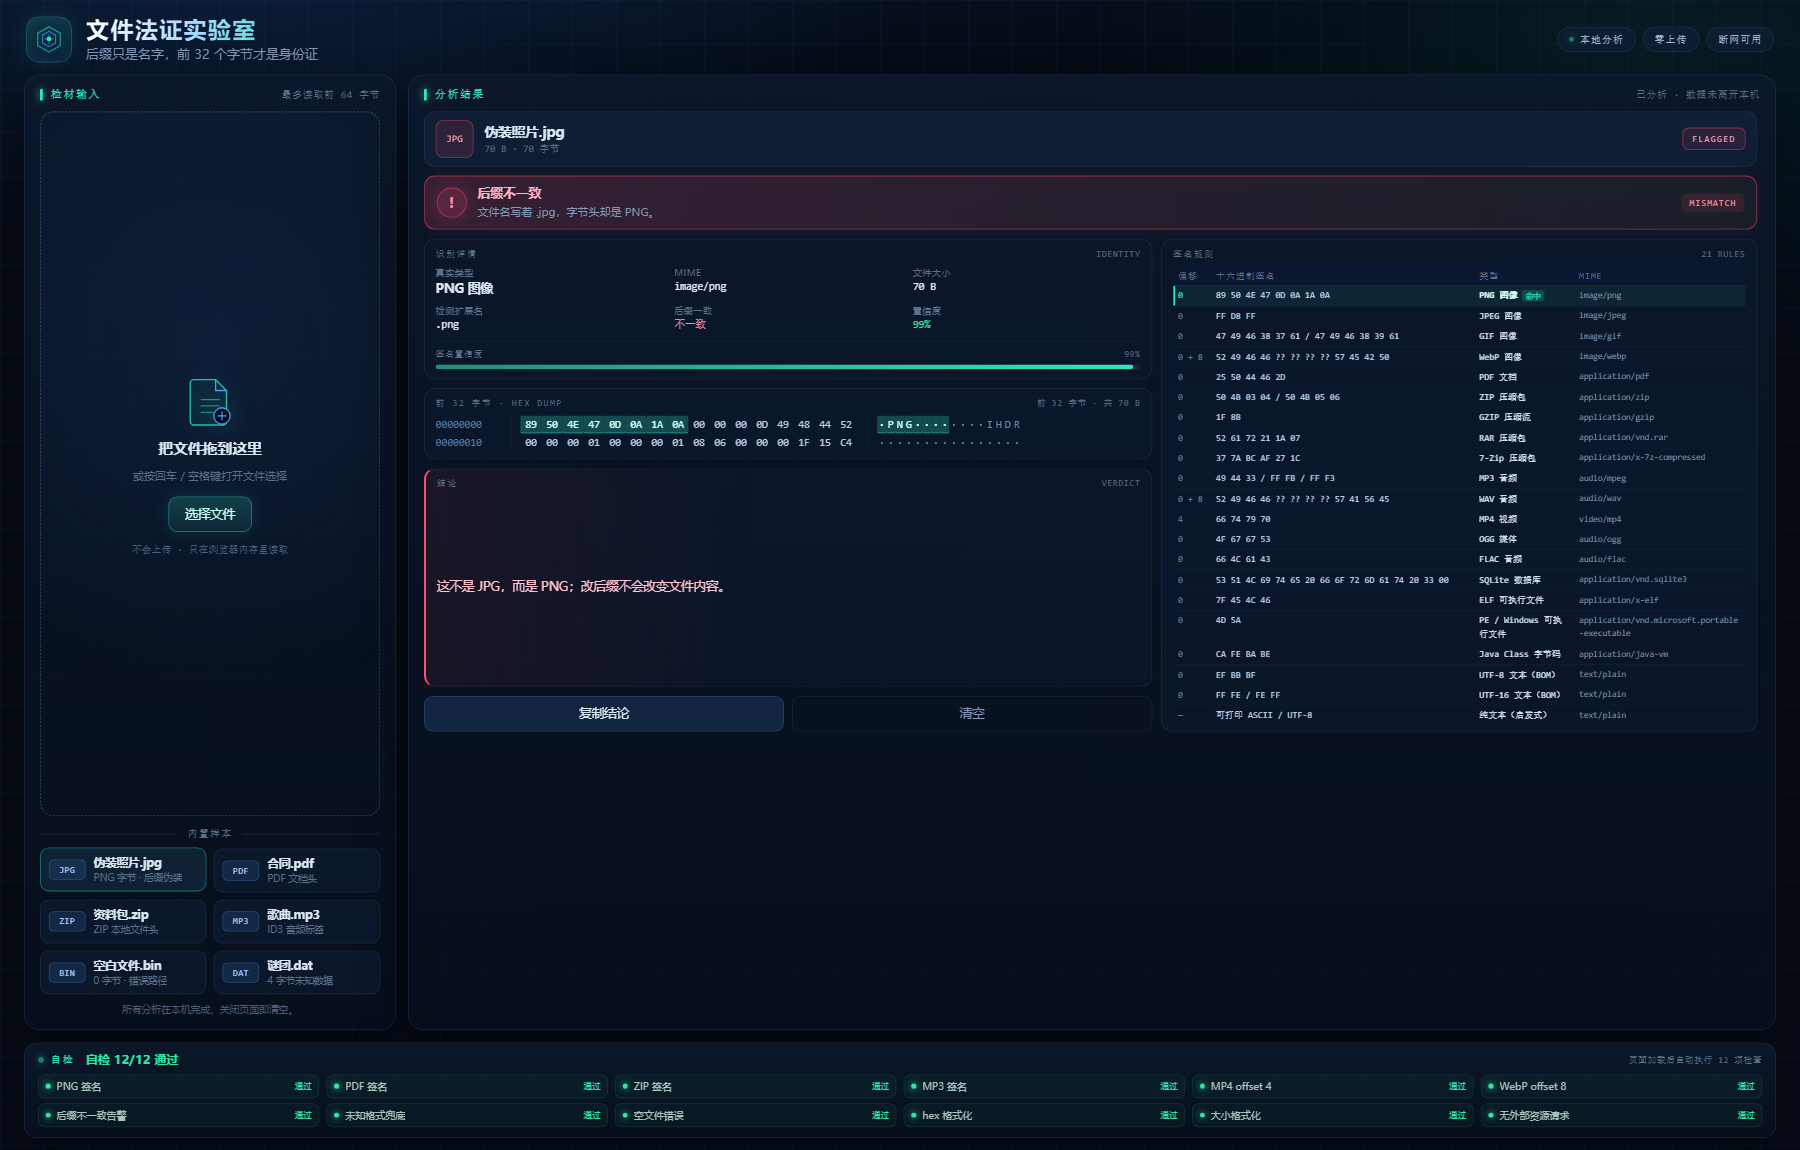
我在页面上点开内置的「伪装照片.jpg」,它只读前 32 个字节,就判出 PNG 图像。
文件大小 70 B,MIME 是 image/png,后缀一致性一栏标红:不一致。
在线案例与源码:https://atomgit.com/deli007/demo_park/tree/main/codearts-file-magic-lab
成品只有一个index.html,零依赖、无外链,断网可用。文里的字节和数字,我都在页面上点过一遍。
一、为什么值得看:后缀是最容易撒谎的元数据
文件后缀是文件名的一部分,不是文件内容的一部分。
同一个 70 B 的 PNG,改名成 .pdf 后,内容仍是 PNG;只是很多系统会先信后缀。
但很多系统先看后缀,或者只看请求里的 MIME。
后缀和内容对不上时,轻则打不开,重则把压缩包当图片、把 HTML 当文本。
这个小工具只回答一个问题:这段字节到底是什么。
| 格式 | 偏移 | 签名(十六进制) | MIME |
|---|---|---|---|
| PNG | 0 | 89 50 4E 47 0D 0A 1A 0A | image/png |
| JPEG | 0 | FF D8 FF | image/jpeg |
| 0 | 25 50 44 46 2D | application/pdf | |
| ZIP | 0 | 50 4B 03 04 | application/zip |
| RAR | 0 | 52 61 72 21 1A 07 | application/vnd.rar |
| 7Z | 0 | 37 7A BC AF 27 1C | application/x-7z-compressed |
| MP4 | 4 | 66 74 79 70 | video/mp4 |
| WebP | 8 | 57 45 42 50 | image/webp |
| MP3 | 0 | 49 44 33 | audio/mpeg |
| SQLite | 0 | 53 51 4C 69 74 65 20 66 6F 72 6D 61 74 20 33 00 | application/vnd.sqlite3 |
页面里一共放了 21 条签名规则。
最容易被忽略的是偏移量不是 0 的格式:MP4 的 ftyp 在 offset 4,WebP 和 WAV 的标记在 offset 8。
只看开头四个字节,MP4 和 WebP 都会漏。
二、准备环境:进入码道 Web
登录后直接在对话框里写需求。
码道有三种使用方式:WebUI(浏览器对话)、TUI(终端命令行)和桌面 IDE(IDE 插件)。
本文用 WebUI 版演示。
这一轮需求我写成一条:单文件、无外链、读前 64 字节、21 条规则、6 个内置样本、12 项自检。
验收条件也一起写进去了:后缀不一致要标红,空文件和未知格式要给中文提示,不能白屏。
生成后页面自己跑出 12/12,我才开始截图。
三、怎么做:读 64 字节,按偏移比对
页面上传只走 FileReader,文件不会发到服务器。
代码很短,核心就一行:
const head = new Uint8Array(await file.slice(0, 64).arrayBuffer());
拿到 64 字节后,按规则表逐条比对偏移和签名。
签名里的 ?? 是通配符,用来跳过 RIFF 后面 4 个长度字节。
命中后,结果卡给出真实类型、MIME、检测扩展名和置信度。
hex dump 显示前 32 字节,命中的签名字节高亮,右边还有 ASCII 列。
规则表同步高亮命中的那一行,读的人不用自己数偏移。
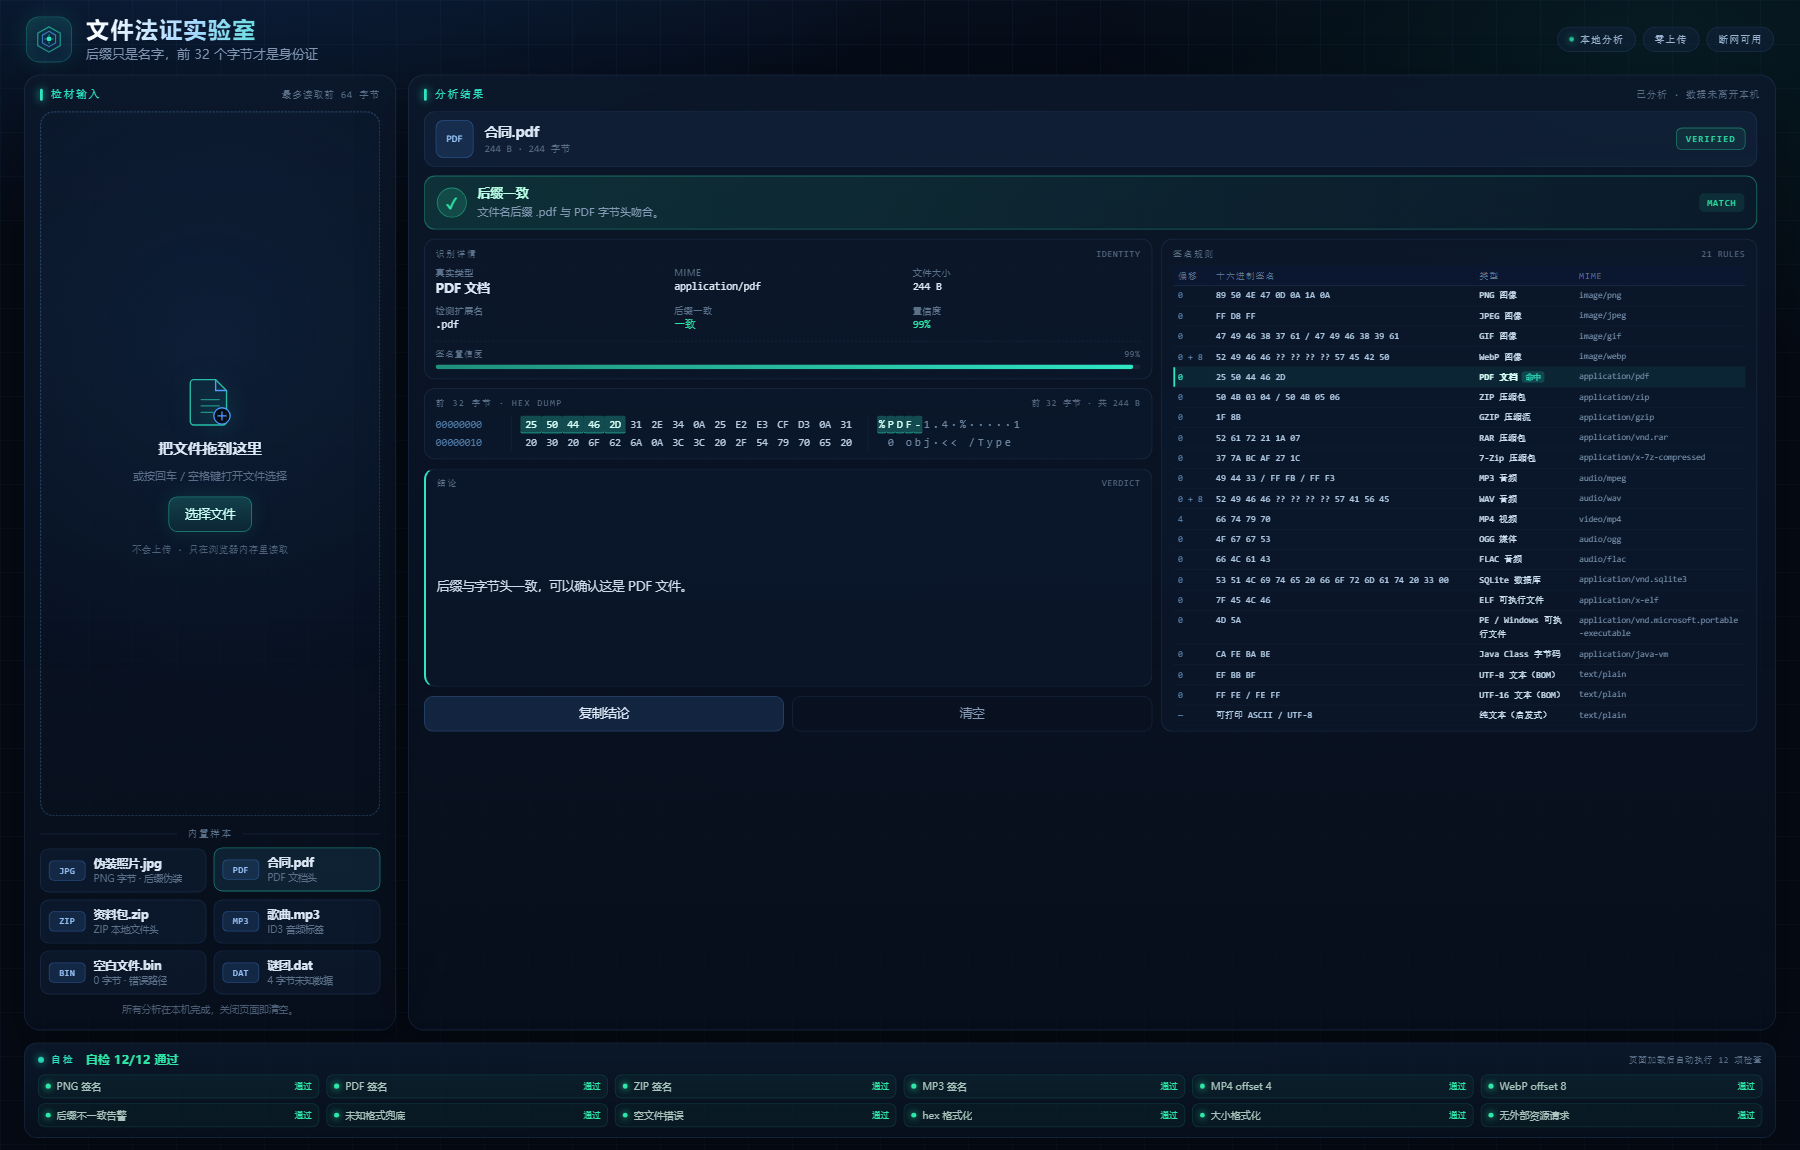
PDF 样本是 244 B,签名 25 50 44 46 2D,规则表只亮 PDF 那一行。
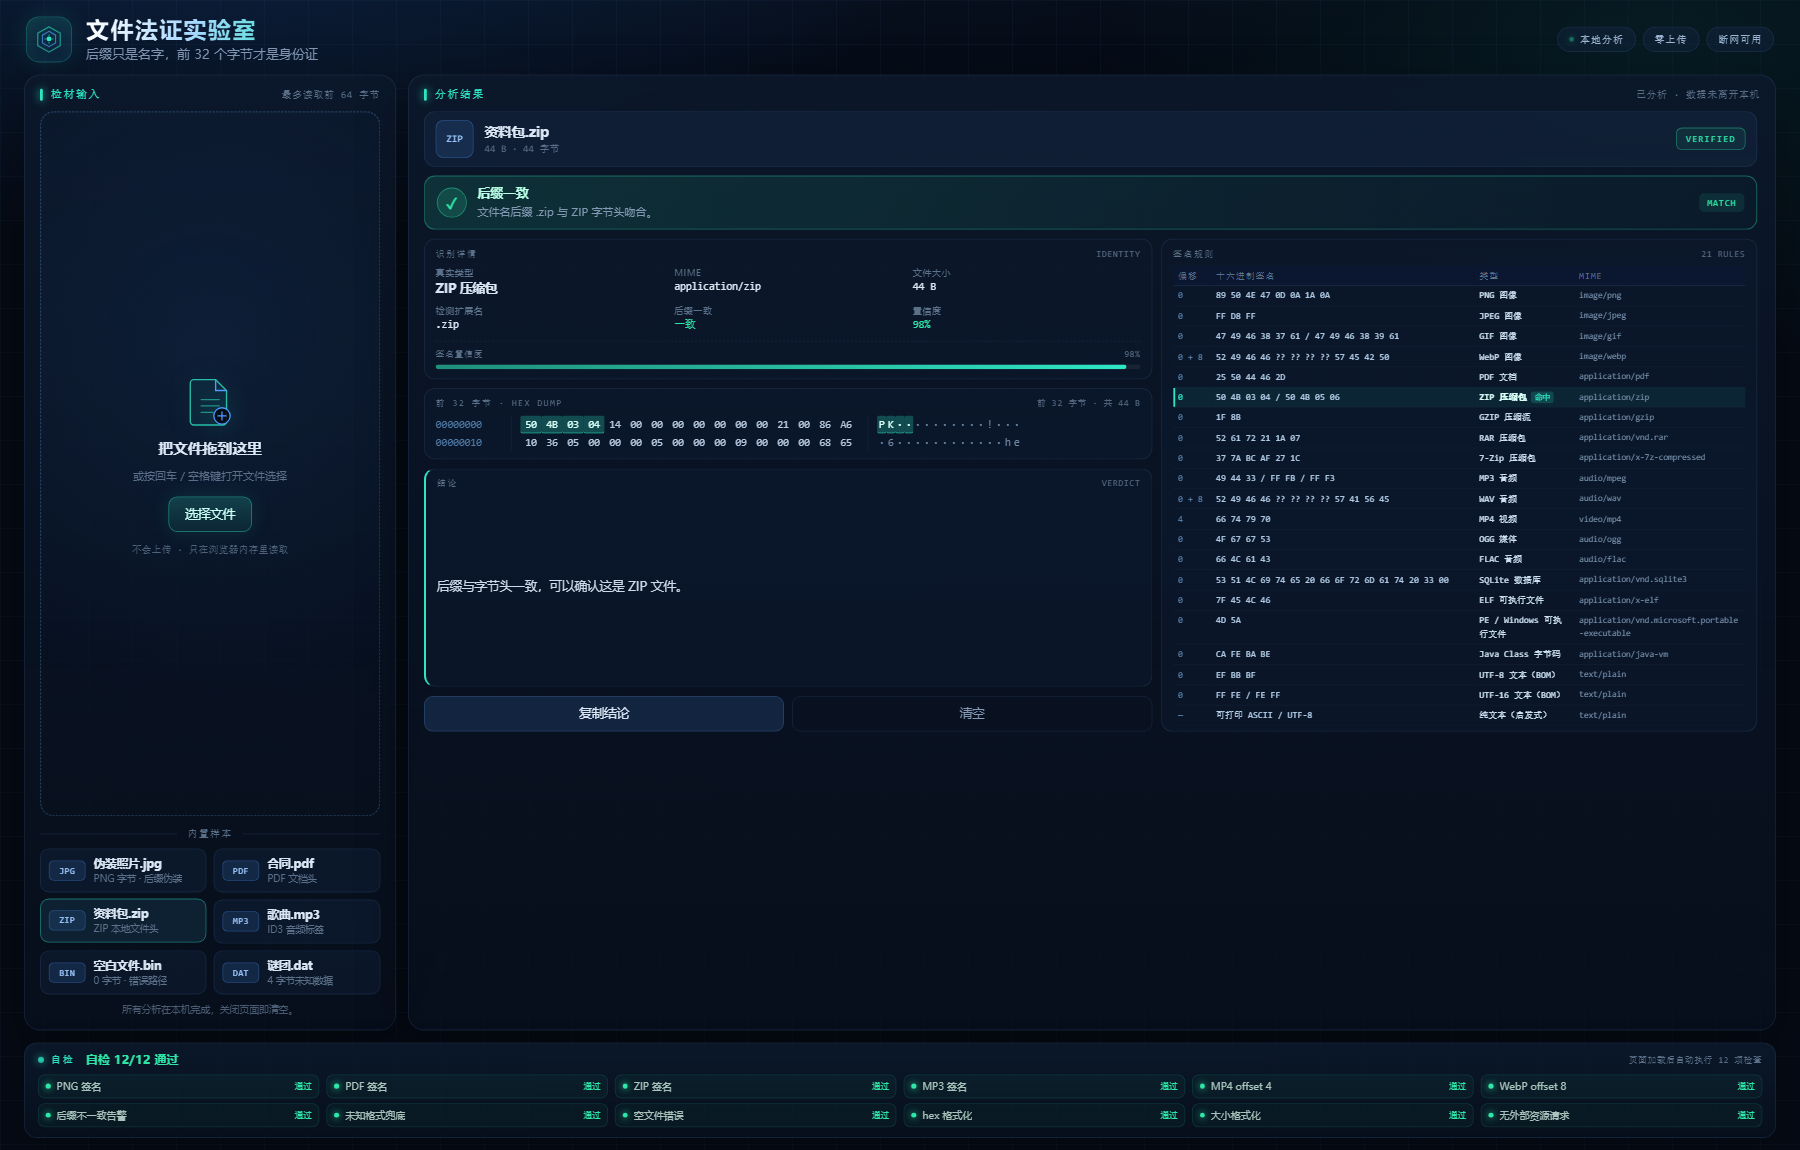
ZIP 样本是 44 B,签名 50 4B 03 04,结论是「后缀与字节头一致」。
四、验证与踩坑:6 个样本、7 个边界、12 项自检
我把 6 个内置样本逐个点了一遍,又把边界用例单独跑了一遍。
| 样本 | 字节数 | 前 8 字节 | 检测结果 | 一致性 |
|---|---|---|---|---|
| 伪装照片.jpg | 70 B | 89 50 4E 47 0D 0A 1A 0A | PNG | 不一致 |
| 合同.pdf | 244 B | 25 50 44 46 2D 31 2E 34 | 一致 | |
| 资料包.zip | 44 B | 50 4B 03 04 14 00 00 00 | ZIP | 一致 |
| 歌曲.mp3 | 26 B | 49 44 33 03 00 00 00 | MP3 | 一致 |
| 空白文件.bin | 0 B | 无 | 读取失败 | — |
| 谜团.dat | 4 B | 00 01 02 03 | 未知 | 无法比对 |
页面自检 12/12 通过。
12 项覆盖 PNG、PDF、ZIP、MP3、MP4 的 offset 4、WebP 的 offset 8、后缀不一致告警、未知格式兜底、空文件错误、hex 格式化、大小格式化和无外部资源请求。
踩坑一:MP4 和 WebP 不能只看开头 4 个字节。
我构造了 20 B 的 MP4 头,检测结果是 MP4;截成前 4 B,结果变成「未知」。
WebP 也一样:16 B 能命中,前 8 B 只剩「未知」。
原因是 MP4 的 ftyp 在 offset 4,WebP 的 WEBP 在 offset 8。
踩坑二:后缀一致不是非黑即白。
.jpeg 和 .jpg 都映射到 JPEG,能判一致。
PNG 字节配 .bin 会显示「通用后缀」,不当作错误。
没有后缀时显示「未提供后缀」,也不硬判。
只有明确预期格式和检测结果冲突,才标红。
踩坑三:2 字节的 PNG 头不能硬判成 PNG。
页面给的是「字节太少,真实类型未知」,并要求至少 4 个字节。
空文件走另一条路:0 B 直接报「文件为空,读不到文件头」。
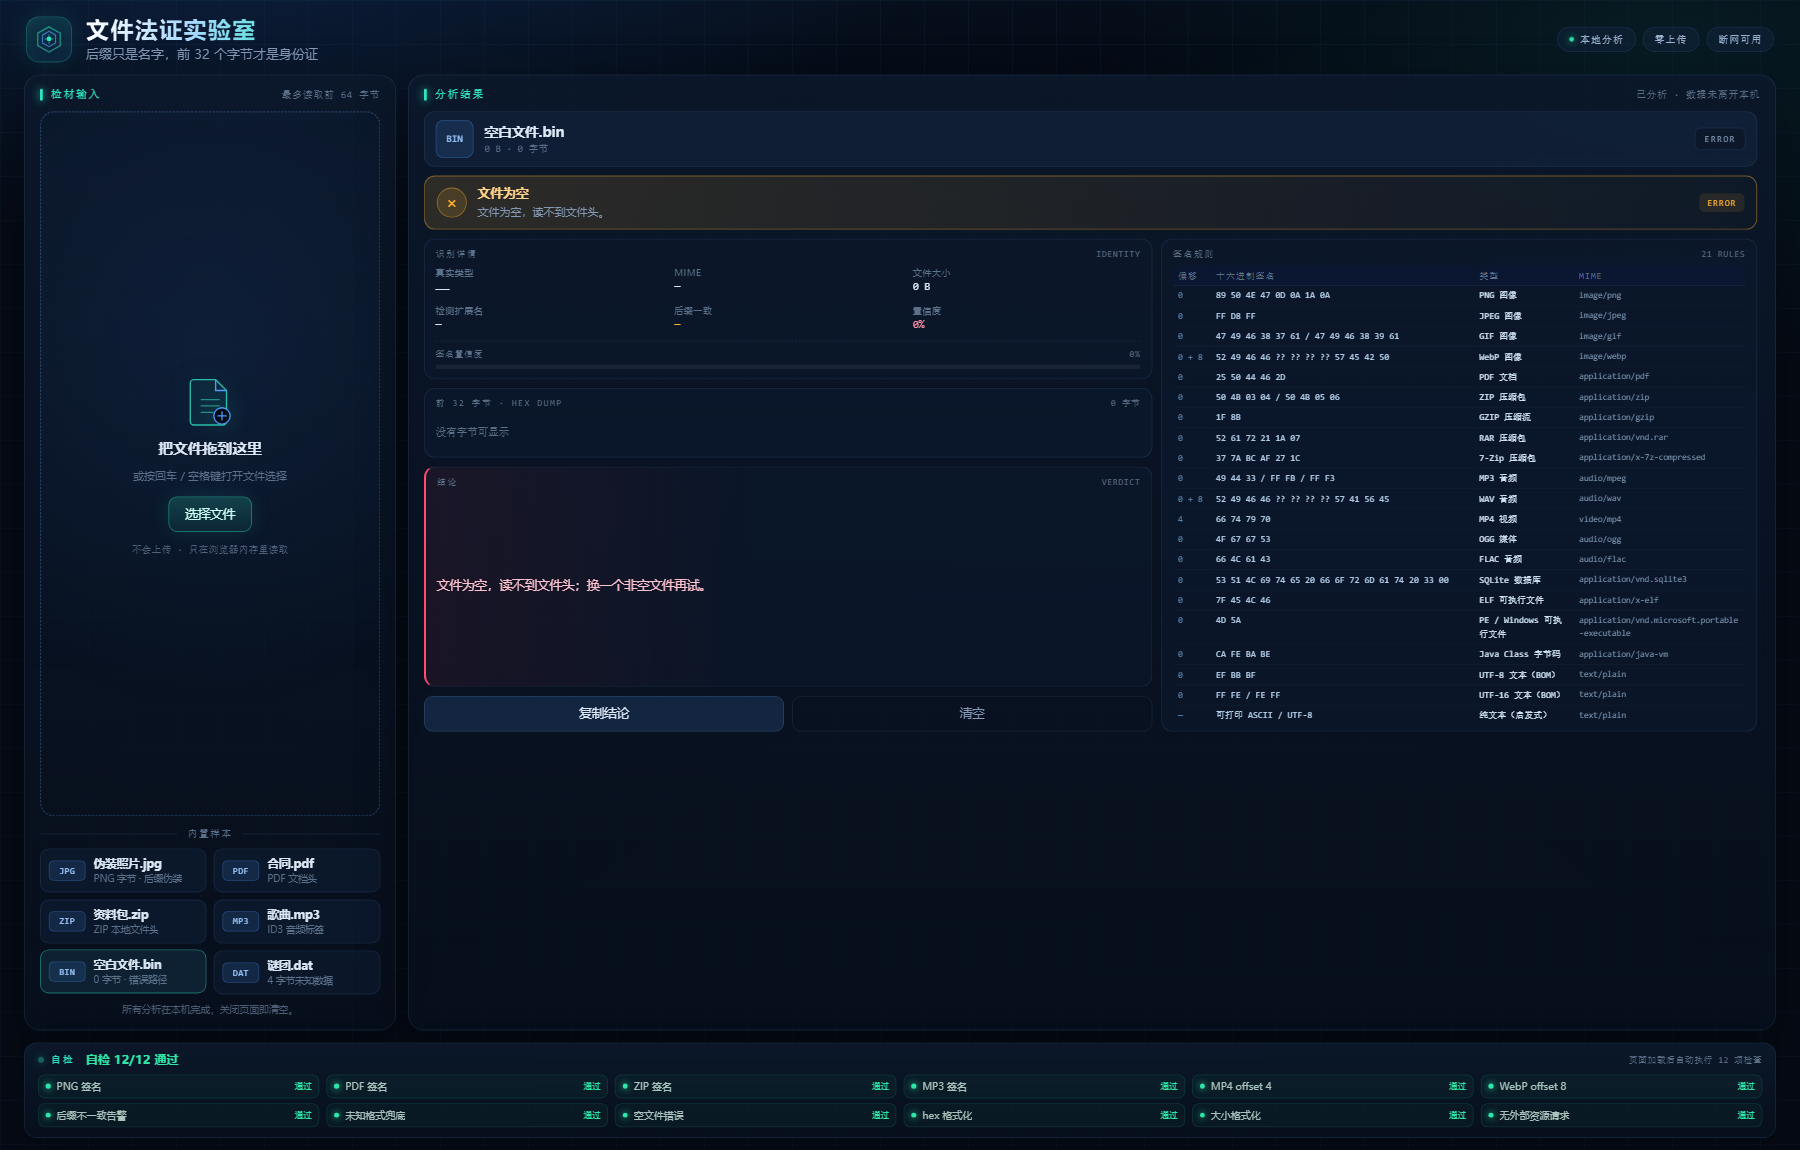
这两条失败路径都没有抛异常,也没有白屏。
| 边界输入 | 字节数 | 检测结果 | 一致性 |
|---|---|---|---|
| MP4 完整头 | 20 B | MP4 | 一致 |
| MP4 前 4 字节 | 4 B | 未知 | 无法比对 |
| WebP 完整头 | 16 B | WebP | 一致 |
| WebP 前 8 字节 | 8 B | 未知 | 无法比对 |
| JPEG 配 .jpeg | 10 B | JPEG | 一致 |
| PNG 配 .bin | 70 B | PNG | 通用后缀 |
| PNG 前 2 字节 | 2 B | 字节太少 | 无法比对 |
这 7 个边界结果都来自页面自己的检测函数,没有另写一份假数据。
五、这个工具验不了什么
- 只读前 64 字节,签名在 64 字节之后的格式会漏。
- 纯文本判断是启发式,随机二进制如果恰好都能打印,也可能被当成文本。
- MIME 是根据字节头给的猜测,不等于服务器返回的 Content-Type。
- 它不做病毒扫描,也不修复文件,只告诉你这段字节像什么。
- 后缀不一致不代表文件一定有问题,可能只是手动改名。
- 21 条规则覆盖常见格式,不等于覆盖全部格式。
六、直接下载和试玩
Demo 的源码、本文档和 5 张截图都在公开仓库里。
- Demo Park 仓库:https://atomgit.com/deli007/demo_park
- 本案例目录:https://atomgit.com/deli007/demo_park/tree/main/codearts-file-magic-lab
本地跑三步。
git clone https://atomgit.com/deli007/demo_park.git
cd demo_park\codearts-file-magic-lab
python -m http.server 8080
浏览器打开 http://localhost:8080/index.html。
先点「伪装照片.jpg」看红色告警,再点「合同.pdf」看绿色通过,最后点「空白文件.bin」看失败路径。
七、使用码道体会:把验收条件写进需求
这次用的是码道 WebUI。
我把验收条件写进需求,生成后页面自己跑自检,省掉了来回猜。
单文件、无外链这个约束也很关键,拿到 index.html 就能本地复现。
如果需求里不写失败路径,生成结果很容易只覆盖顺利情况。
下一步我想把 docx、xlsx 这类 ZIP 容器拆开显示,让「同一个 PK 头,里面到底是什么」也能看见。
文件类型这件事,最可靠的不是后缀,而是字节。

- 点赞
- 收藏
- 关注作者
评论(0)