为什么你等的电梯总是不来?3 部电梯 12 层 SCAN 调度实测

同一栋 12 层楼、3 部电梯、同一批 315 人,30 人/分钟的早高峰:LOOK 平均等 4.1 秒,NEAREST 4.5 秒,SCAN 5.2 秒,FCFS 7.4 秒。
差距最大的是空驶。LOOK 全程跑了 932 层,NEAREST 跑了 1160 层,多出 24.5%。
你按下的按钮,其实是在替整栋楼排一次队。
一、先看结果:四种策略,等待差 3 倍
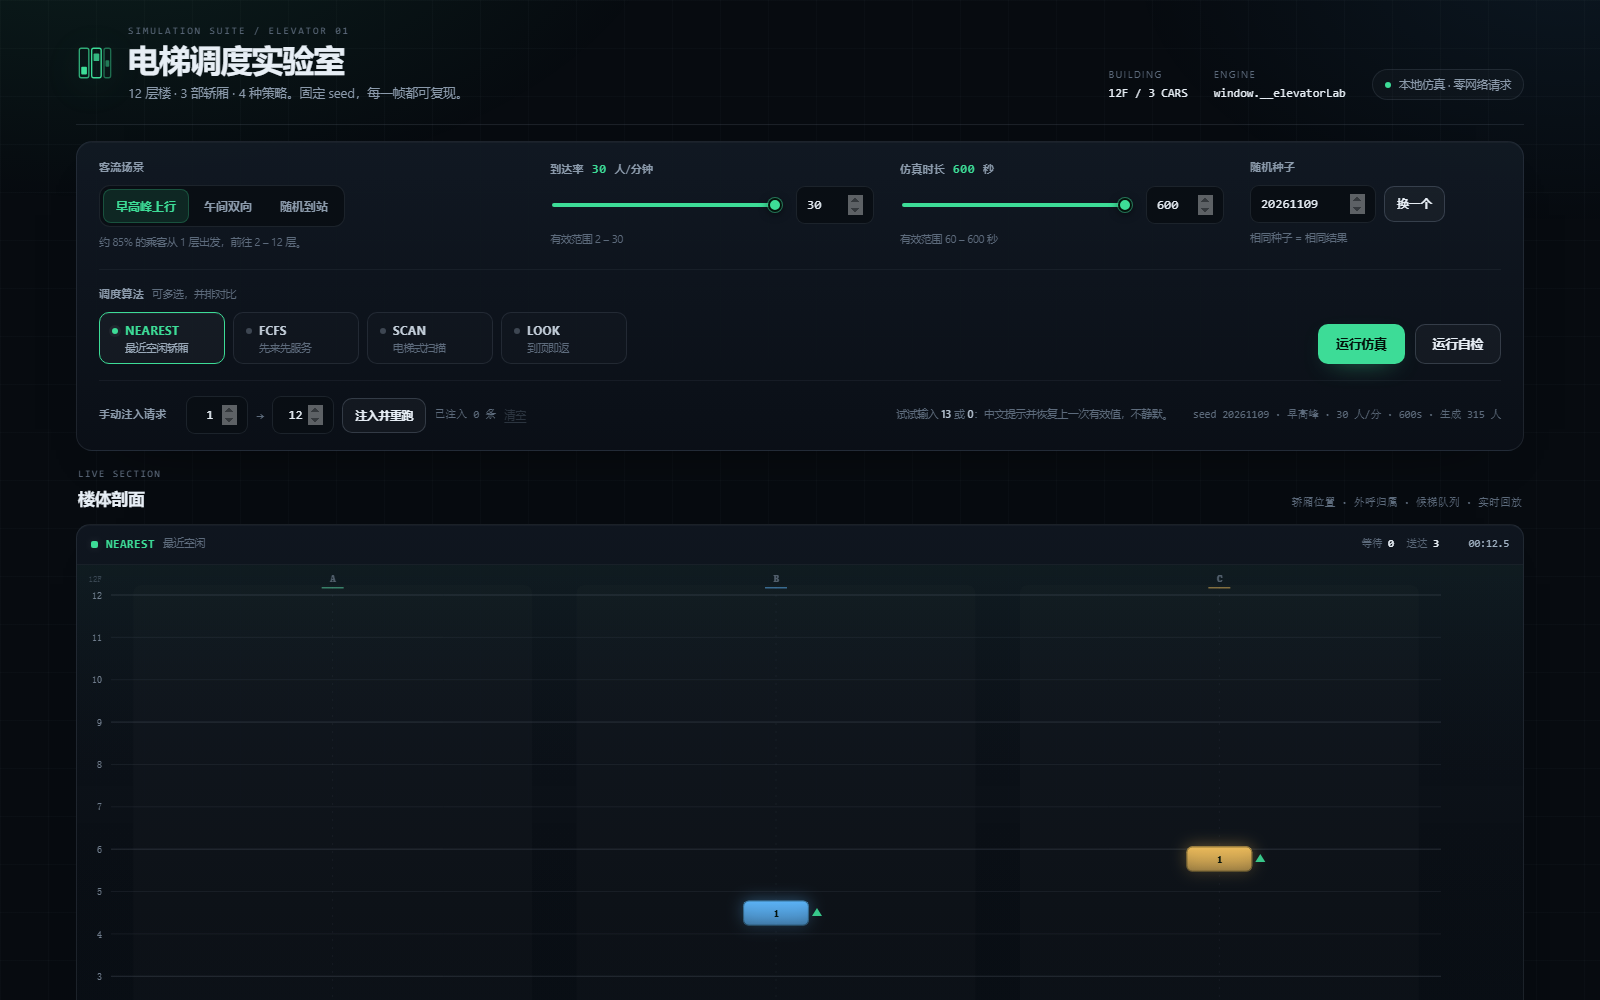
先固定客流:早高峰上行,30 人/分钟,仿真 600 秒,随机种子 20261109。
四种算法拿到完全相同的请求流,结果如下。
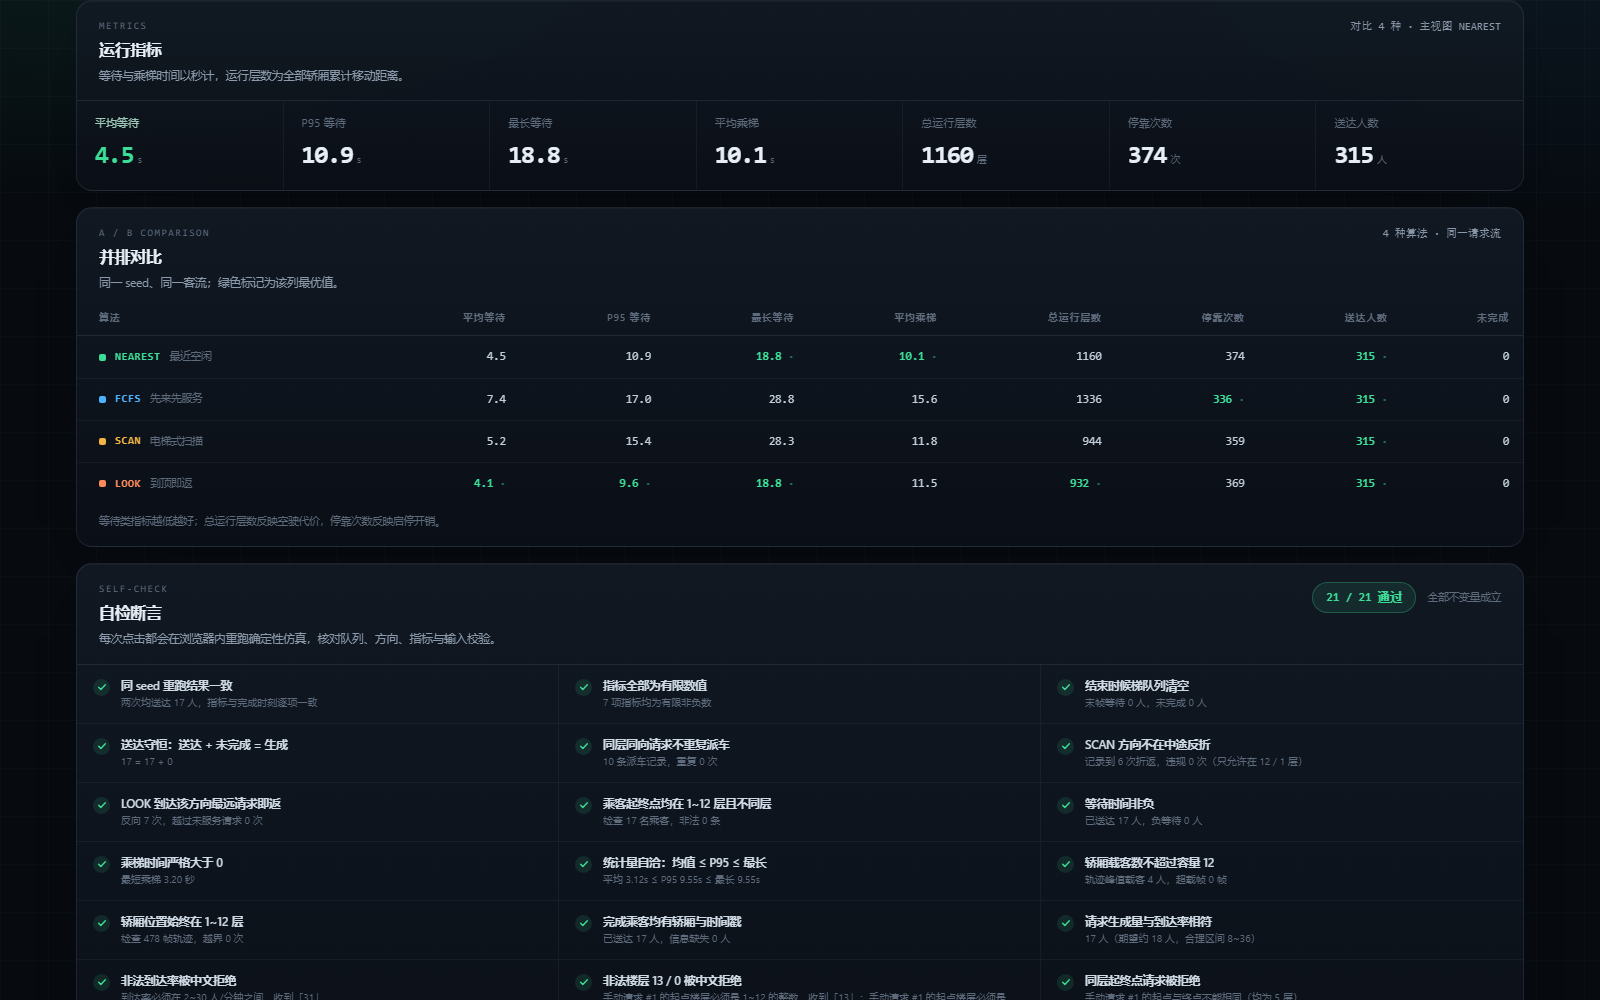
| 策略 | 平均等待 | P95 等待 | 最长等待 | 平均乘梯 | 总运行层数 | 停靠次数 | 送达 |
|---|---|---|---|---|---|---|---|
| NEAREST 最近空闲 | 4.5 s | 10.9 s | 18.8 s | 10.1 s | 1160 层 | 374 次 | 315 人 |
| FCFS 先来先服务 | 7.4 s | 17.0 s | 28.8 s | 15.6 s | 1336 层 | 336 次 | 315 人 |
| SCAN 电梯式扫描 | 5.2 s | 15.4 s | 28.3 s | 11.8 s | 944 层 | 359 次 | 315 人 |
| LOOK 到顶即返 | 4.1 s | 9.6 s | 18.8 s | 11.5 s | 932 层 | 369 次 | 315 人 |
四个策略都把 315 人送完了,未完成 0 人。
平均等待最好的是 LOOK,最差的是 FCFS,相差 3.3 秒。
但单看平均等待会漏掉一半信息。NEAREST 的平均等待只比 LOOK 慢 0.5 秒,空驶却多了 228 层。
换成午间双向和随机到站,排名又变了。
| 客流 | NEAREST | FCFS | SCAN | LOOK |
|---|---|---|---|---|
| 早高峰上行 30 人/分 | 4.5 s | 7.4 s | 5.2 s | 4.1 s |
| 午间双向 30 人/分 | 4.6 s | 13.1 s | 3.9 s | 4.5 s |
| 随机到站 30 人/分 | 4.8 s | 15.0 s | 5.7 s | 5.2 s |
FCFS 在单向早高峰只是慢一点,到了双向和随机客流直接掉队。
午间 13.1 秒,是 SCAN 3.9 秒的 3.4 倍。随机客流 15.0 秒,是 NEAREST 4.8 秒的 3.1 倍。
这不是实现 bug,是策略本身的问题。
二、为什么值得看:电梯是每天在跑的调度题
等电梯的痛点不是慢,是不确定。
你看见 A 车停在 3 层,按了上行键,结果来的却是刚从 12 层往下走的 C 车。
电梯调度和线程池、限流器是同一类问题:请求随时到,服务能力有限,决策只能看当前状态。
它比多数后端面试题更诚实。你没法预知下一分钟谁会按按钮,也没法把已经出发的轿厢收回来。
12 层、3 部轿厢、每部最多 12 人,这个规模足够小,能在浏览器里一帧一帧算清楚。
也足够大,能暴露「每部车各管各的」和「整栋楼统一排队」的差别。
三、怎么算:把每部电梯当成一台会记账的扫描机
模型只有几个常数:12 层、3 部轿厢、容量 12 人、速度 1.15 层/秒。
开关门时间按 1.25 秒加每人 0.09 秒计算,仿真步长 0.1 秒。
乘客按泊松过程到达,起点、终点和方向都由固定 seed 生成。
一部轿厢只接同方向的请求,先下后上,坐满 12 人就不再上客。
四种策略的差别,只在「把哪个请求派给哪部车」。
| 策略 | 派车规则 | 强项 | 弱项 |
|---|---|---|---|
| NEAREST | 挑预计到达最近的空闲轿厢,全忙时挑最早空出来的 | 单个请求响应快 | 各车各自为战,空驶多 |
| FCFS | 按请求到达顺序,依次派给下一部车 | 实现最简单,先到先得 | 车流交叉,双向客流容易崩 |
| SCAN | 沿当前方向扫到顶层或底层,再折返 | 顺路收同向请求,省空驶 | 没有请求也扫到端点,P95 变差 |
| LOOK | 扫到该方向最远的请求就折返 | 早高峰等待和空驶都低 | 方向切换频繁时不如 SCAN |
SCAN 和 LOOK 只差一个折返条件,实测差距却不小。
原因在后面:SCAN 会为了「扫完这一趟」多走几层,LOOK 不会。
四、实测:同一批人,四种策略,差距 3 倍
先看早高峰。
LOOK 的平均等待 4.1 秒,比 NEAREST 低 10.2%,总运行层数少 19.7%。
SCAN 的平均等待 5.2 秒,反而比 NEAREST 慢 15%。
它省了空驶,944 层对 1160 层,少了 18.6%,但代价落在长尾上。
SCAN 的 P95 是 15.4 秒,LOOK 是 9.6 秒。SCAN 的最长等待 28.3 秒,LOOK 是 18.8 秒。
这就是「平均好看、体验不好」的典型。
再看负载变化。
| 早高峰到达率 | NEAREST | FCFS | SCAN | LOOK |
|---|---|---|---|---|
| 10 人/分 | 4.8 s | 4.8 s | 4.2 s | 4.4 s |
| 20 人/分 | 4.1 s | 4.7 s | 4.7 s | 3.9 s |
| 30 人/分 | 4.5 s | 7.4 s | 5.2 s | 4.1 s |
10 人/分钟时,SCAN 最好,4.2 秒,比 NEAREST 低 13.8%。
20 人和 30 人/分钟时,LOOK 最好。
负载低的时候,请求稀疏,SCAN 的整趟扫描刚好把沿路的人捎上。
负载高的时候,顶层经常没人,SCAN 还要空跑上去,LOOK 提前折返的优势就出来了。
午间双向又是另一回事。
SCAN 3.9 秒,NEAREST 4.6 秒,LOOK 4.5 秒。
上下行都有请求时,固定方向扫一趟能把两个方向的队都收掉一部分,SCAN 的「笨办法」反而稳。
所以不存在一个永远最优的算法。得看你所在楼宇的客流形状。
五、验证与踩坑:21 条断言只证明「算对了」
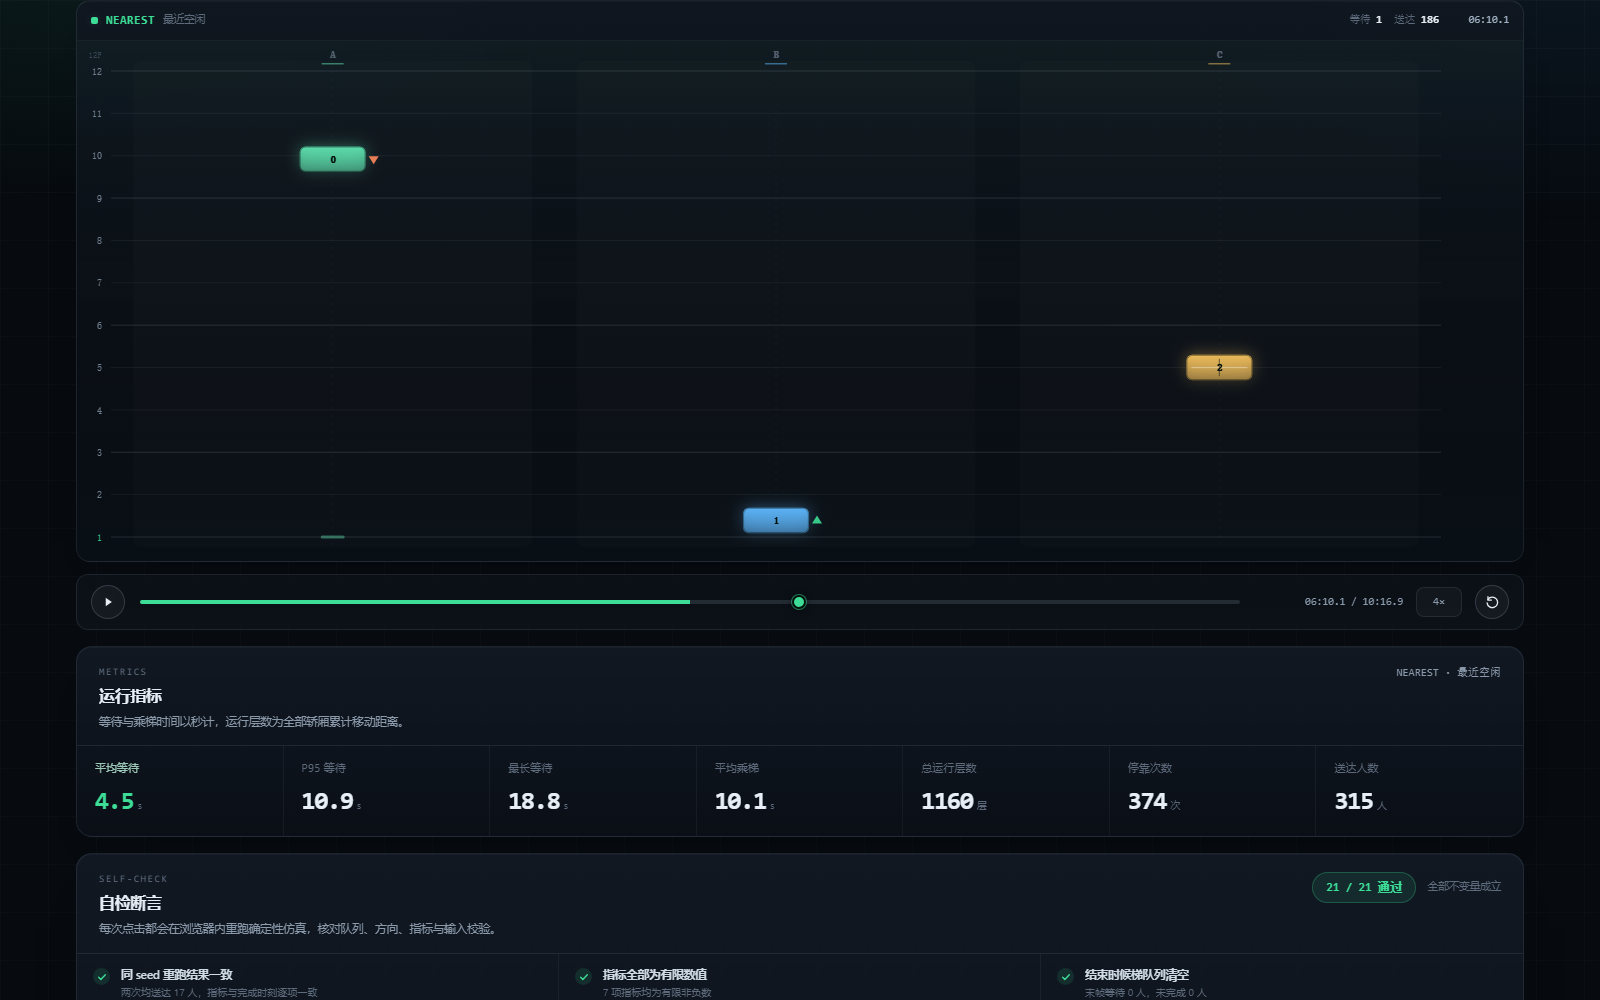
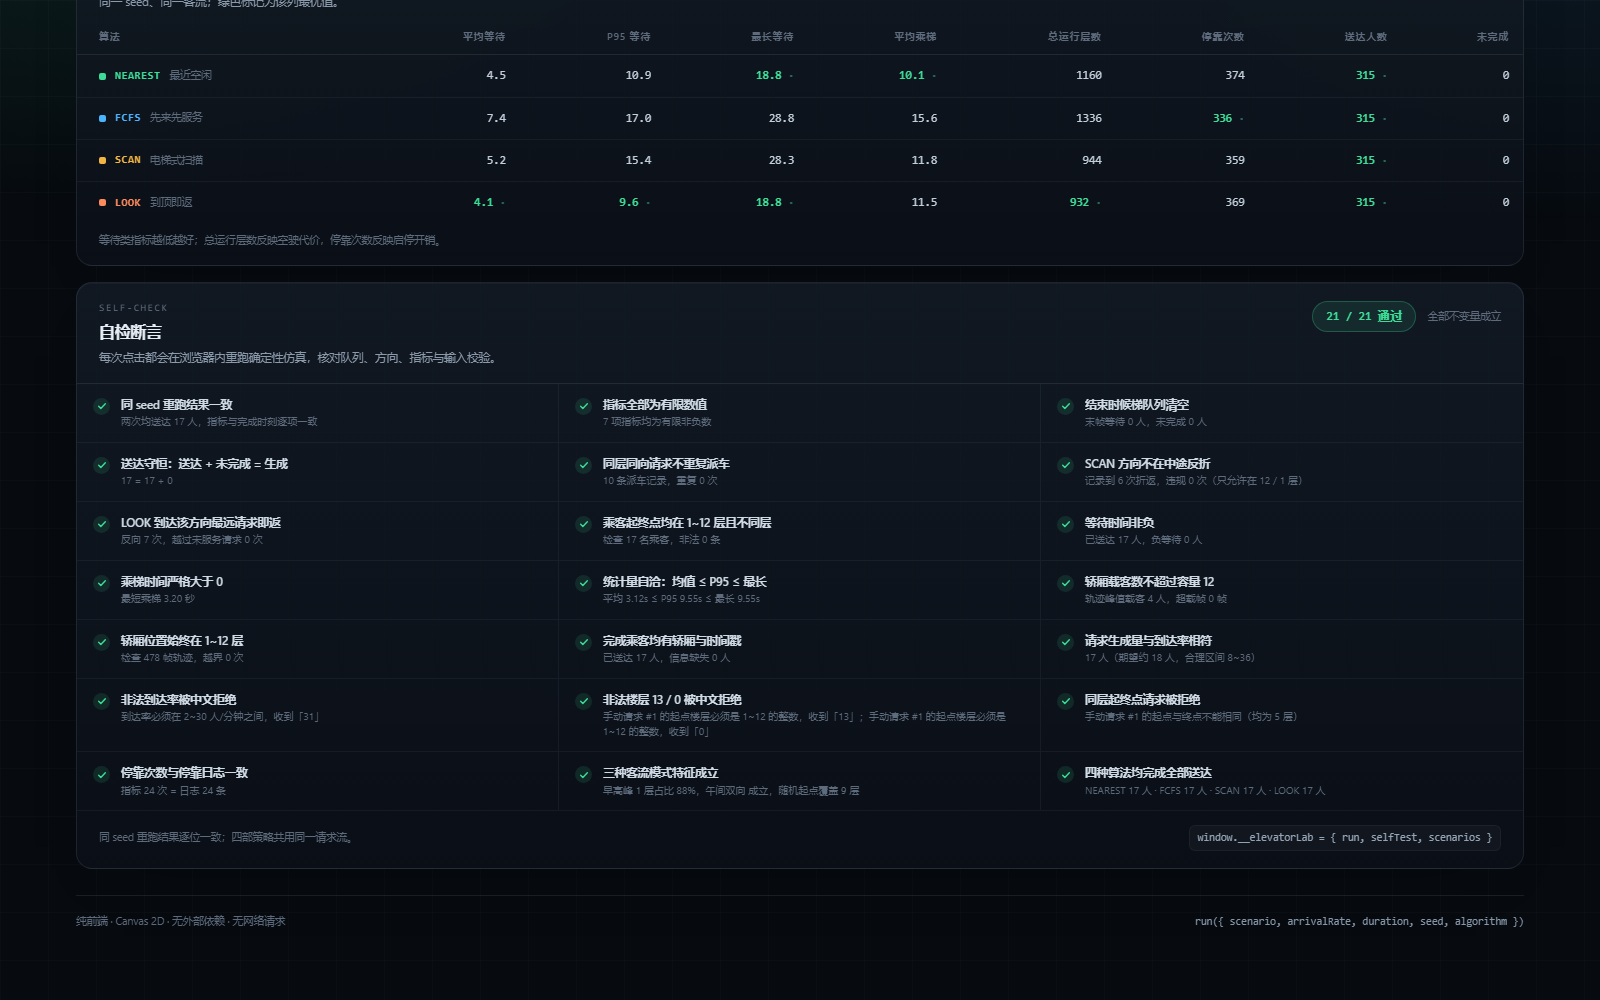
页面底部有 21 条自检,全部在浏览器里现算,当前 21/21 通过。
覆盖的范围包括:同 seed 两次结果逐项一致、结束时候梯队列清空、送达人数守恒、同层同向请求不重复派车。
还有 SCAN 不在中途反折、LOOK 不越过未服务请求、轿厢不超载、位置不越界、等待时间非负。
输入校验也在里面:楼层 13、楼层 0、起终点同层、到达率 31,都会被中文拒绝。
但自检全绿,只说明算法没算错,不说明读数没读错。
我一开始就踩了一个读数坑。
页面徽章写着 21/21,断言详情里却写着「两次均送达 17 人」,而当前主界面跑的是 315 人。
原因是自检用了自己的固定夹具:12 人/分钟、90 秒、种子 20261108,和主界面的参数无关。
17 人对的是自检夹具,不是你那一次 600 秒的仿真。
看懂这一点之后,徽章归徽章,指标归指标,两者不要混着引用。
失败路径也走了一遍。
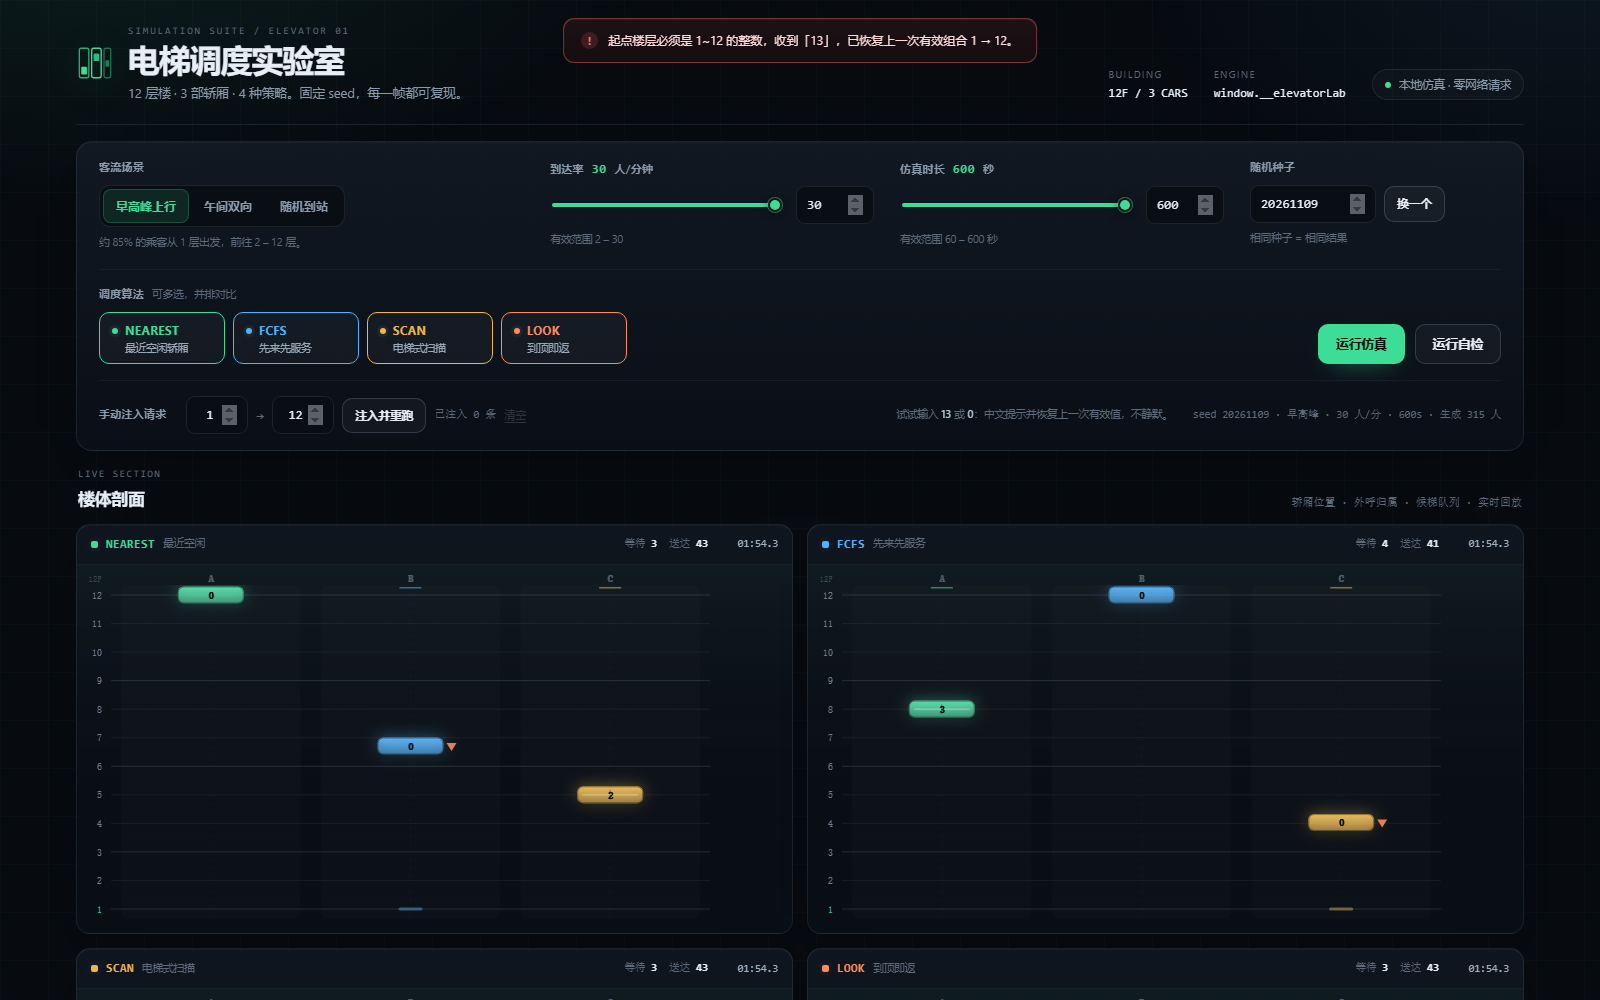
手动输入起点 13 层,点「注入并重跑」,页面顶部弹出:
「起点楼层必须是 1~12 的整数,收到「13」,已恢复上一次有效组合 1 → 12。」
输入框同时回到 1,队列没有被污染。
到达率填 31、时长填 601,提示类似,都会恢复上一次有效值。
极低负载也试了:2 人/分钟、60 秒,只生成 1 名乘客,平均等待 0.049 秒,没有出现除零或 NaN。
六、本地复现:一个 HTML 文件,两条命令
整个应用是一个 index.html,没有框架,没有外部请求。
把它放到任意目录,执行:
python -m http.server 8080
浏览器打开 http://localhost:8080 就能跑。
仿真引擎挂在全局对象上,可以直接在控制台复算:
window.__elevatorLab.run({
  scenario: "morning",
  arrivalRate: 30,
  duration: 600,
  seed: 20261109,
  algorithm: "LOOK"
}).metrics
同一个 seed、同一组参数,返回的指标逐位一致。
七、准备环境:进入码道 Web
码道有三种使用方式:WebUI(浏览器对话)、TUI(终端命令行)和桌面 IDE(IDE 插件)。本文用 WebUI 版演示。
这一轮的需求写得很具体:12 层 3 部轿厢、4 种策略、固定 seed、页面自检、中文错误提示、暴露 run 和 selfTest。
还有一句固定尾巴:「完成后打开预览,让我直接看到运行效果」。
八、使用码道体会:需求写到可验收,生成才省事
这次一轮就生成了 100 KB 左右的单文件,四种策略、楼体剖面、对比表、21 条自检都在。
自检不是占位文案。同 seed 复现、方向反折、容量越界这些断言,确实在页面里现算。
真正省时间的是那句「把引擎暴露成 window.__elevatorLab」。
有了这个入口,我不用点按钮,直接在控制台跑 20 组参数,把 4 种策略、3 种客流、3 档到达率全扫了一遍。
如果只靠截图点按钮,这一轮至少要多花半小时。
它没做好的地方也有。
自检夹具没有写在页面上,只写了「每次点击都会在浏览器内重跑确定性仿真」。
对开发者够用,对普通读者就是误导。我建议后续把夹具参数直接印在徽章旁边。
还有,四种算法的「谁更好」取决于客流,页面没有给结论,只给数据。这反而是对的。
九、边界与下一步
这版模型刻意做小,有几个东西没算。
没有目的楼层派梯,乘客只能在大厅按键,不能提前告诉系统去几层。
没有换乘,不能先坐 A 车到某层再换 B 车。
没有门被挡住、没有超重、没有乘客拖行李,开关门时间也只是一个线性近似。
所以表里的「平均等待 4.1 秒」是模型输出,不是某栋真实写字楼的实测值。
它能回答「同一批请求,四种策略谁更稳」,不能回答「你们公司电梯为什么天天坏」。
下一步我想加两个东西。
一个是目的楼层派梯,把终点提前纳入派车决策。
另一个是能耗模型,把启停和空驶折算成电费,而不是只数层数。
十、总结
三个结论可以直接拿走。
第一,最近的轿厢不等于最快的方案。NEAREST 对单个请求反应快,但整栋楼的空驶多了 24.5%。
第二,FCFS 只适合单向轻负载。一旦双向或随机客流上来,它的等待时间会翻到 3 倍。
第三,SCAN 和 LOOK 的差别在长尾。SCAN 省空驶但 P95 差 60.9%,LOOK 在早高峰更稳。
如果你也在做调度类功能,建议先固定请求流,再把策略并排跑一遍。
先看 P95 和最长等待,再看平均值。平均值会把最难受的那批人藏起来。
案例目录和可运行文件在这里:https://atomgit.com/deli007/demo_park/tree/main/codearts-elevator-dispatch-lab

- 点赞
- 收藏
- 关注作者
评论(0)