布隆过滤器参数实测:120KB 装 10 万条 URL,k 开到 20 反而更差

给 10 万条 URL 做去重,布隆过滤器要开多大内存?
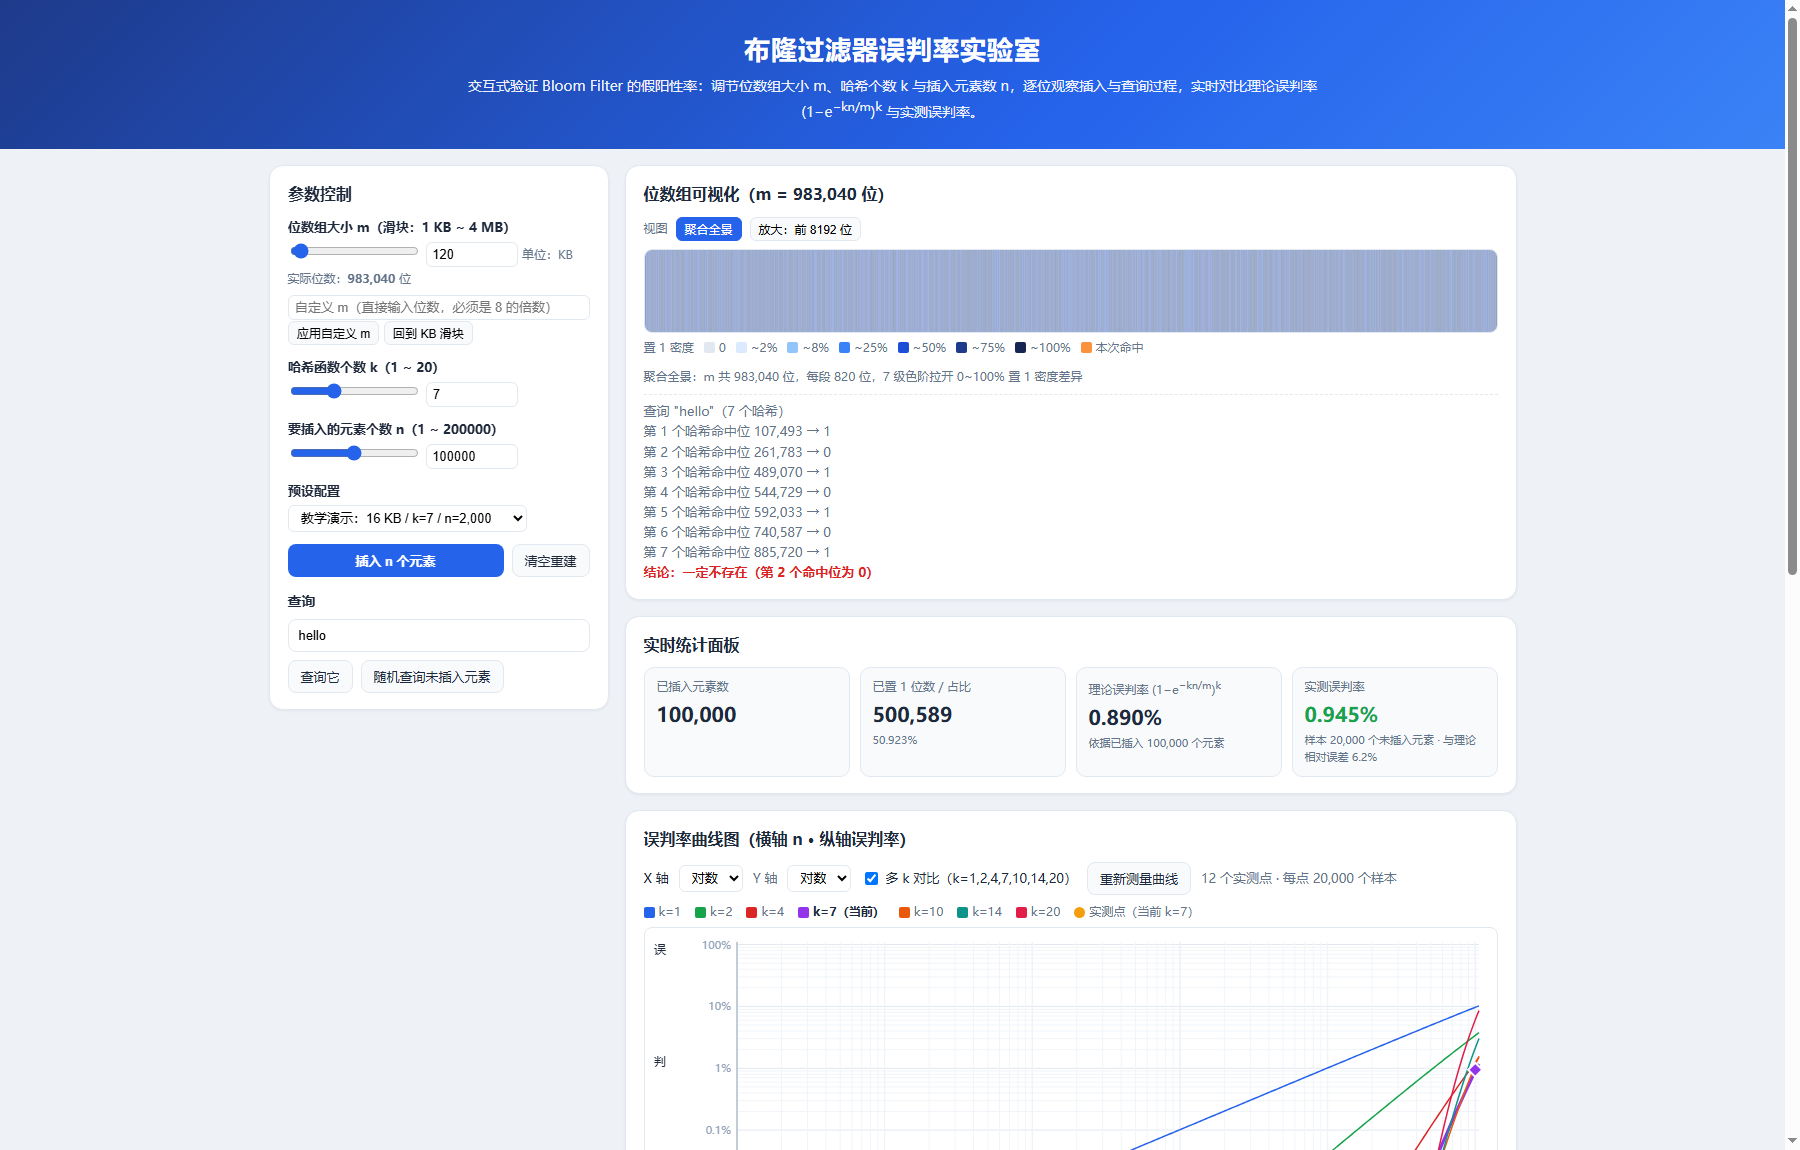
我把这个问题做成了一个能自己跑的页面:位数组 120KB(983,040 位)+ 7 个哈希函数,插入 10 万条数据,实测误判率 0.945%,理论值 0.890%,两者只差 6.2%。
同一块 120KB 内存,把哈希个数 k 从 7 加到 20,误判率反而涨到 5.675%;把内存从 120KB 加到 1MB,20,000 次查询一次都没误判——多出来的 0.9MB,大部分场景是用不上的。
这篇只讲三件事:内存开多大、k 取几个、这两件事怎么用实测数据验证。
一、先说结论:10 万条 URL,120KB 就够(附速查表)
布隆过滤器的误判率不由代码写得好不好决定,只由三个数决定:位数组大小 m、哈希函数个数 k、要存多少元素 n。反过来按目标误判率推,结论很干脆:
| 目标误判率 | 每条数据分到多少位(m/n) | 10 万条 URL 需要的内存 | 最优哈希个数 k* |
|---|---|---|---|
| 10% | 4.8 位 | 59 KB | 3 |
| 1% | 9.6 位 | 117 KB | 7 |
| 0.1% | 14.4 位 | 176 KB | 10 |
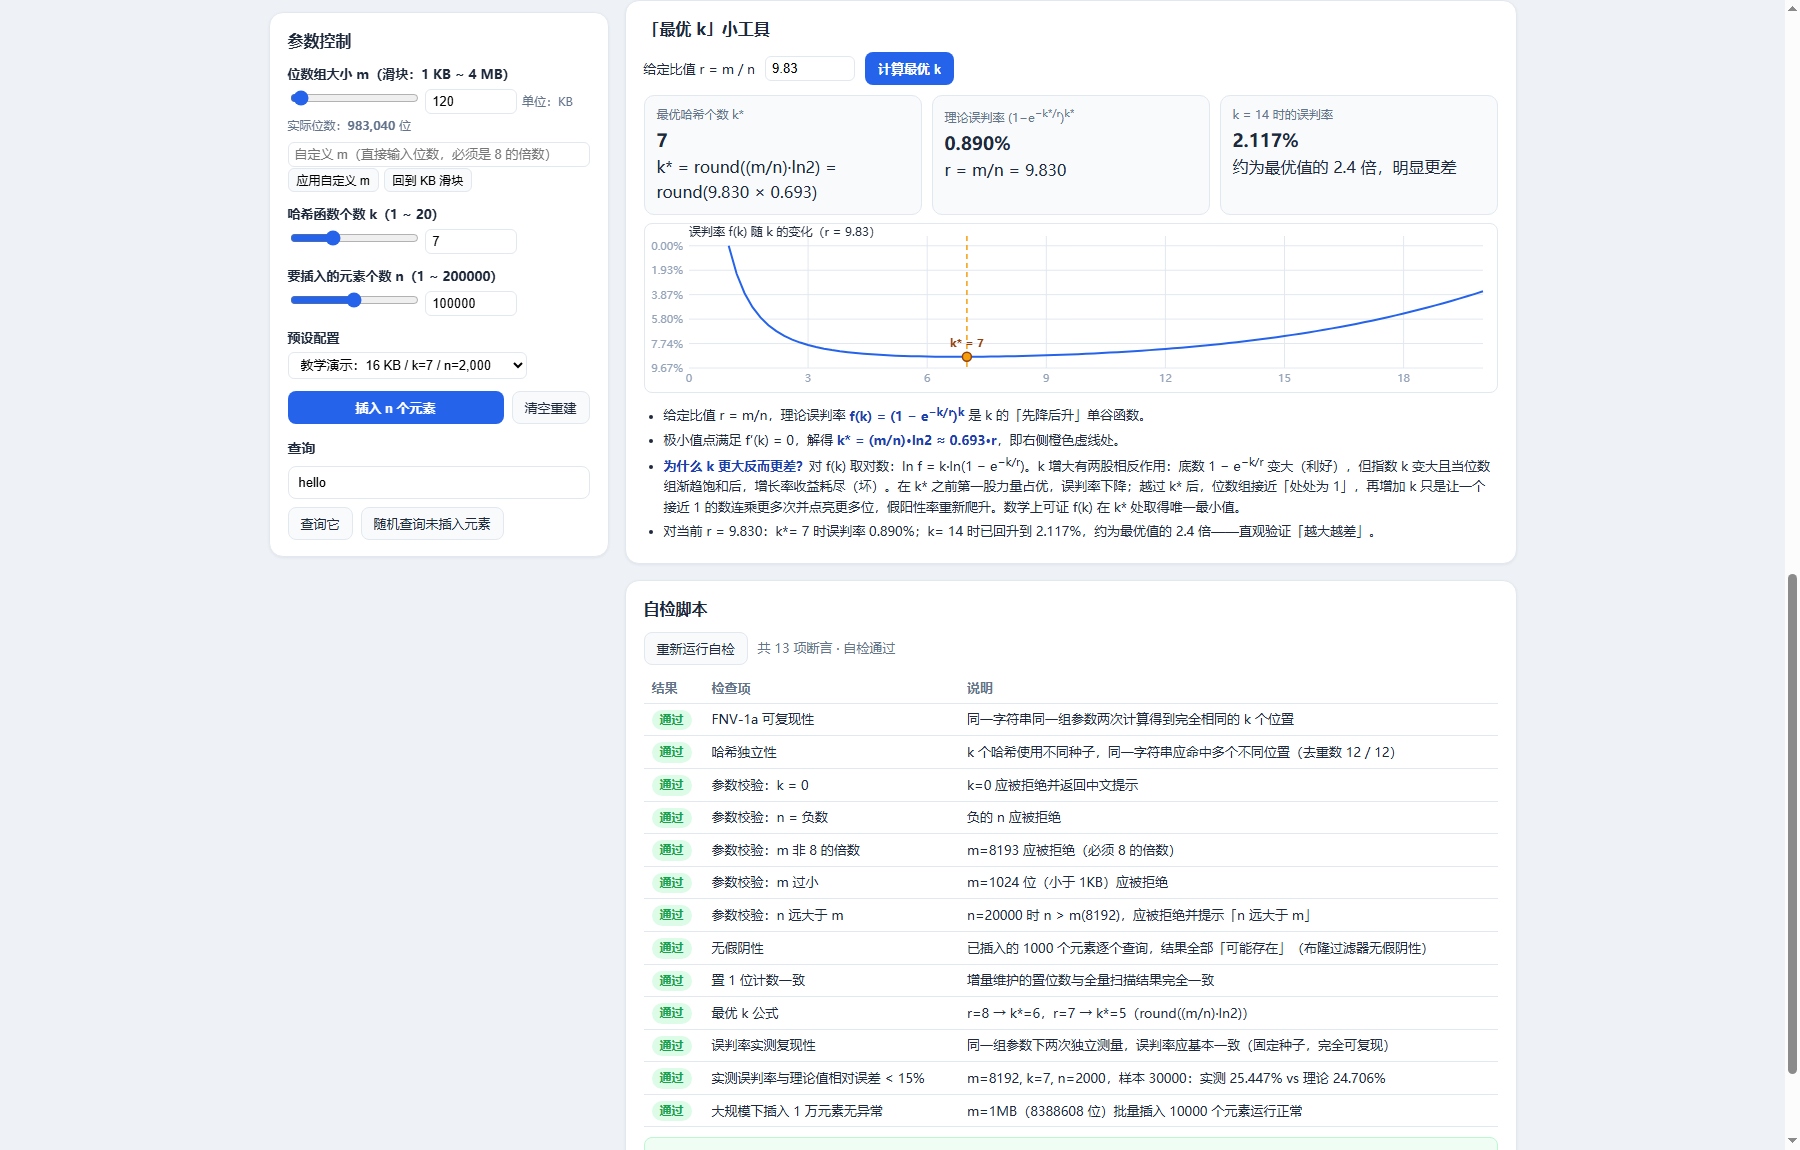
表里的 k* 有解析解:k* = round((m / n) × ln2),不用试凑;内存按 m / 8 换算成字节。
10 万条 URL 想压在 1% 误判率以内,120KB 左右就够了,大约是一张普通网页配图的大小。而且很多场景根本不需要压到 1%:爬虫 URL 去重、缓存穿透拦截这类用途,1%~10% 都能接受——因为误判的代价只是「多查一次数据库」,不是「答错」。
二、为什么 120KB 能装下 10 万条:一次查询到底发生了什么
布隆过滤器的结构非常朴素:一个长度为 m 的位数组,初始全是 0,外加 k 个哈希函数。
- 插入一条数据:把这条数据分别喂给 k 个哈希函数,得到 k 个位置,把这 k 位全部置 1。
- 查询一条数据:同样算出 k 个位置,只要有一位是 0,就可以断定「这条数据一定没插入过」;k 位全是 1,只能说「可能存在」。
它换取的代价就在这里:1 个位只存 1 bit 信息,一条 URL 却要占用 k 个位,所以它天生只能回答「一定不存在 / 可能存在」。好处是省内存——10 万条 URL 原样存下来少说几 MB,压成 120KB 的位图,代价是 1% 的假阳性。
而且这个假阳性是单向的:已插入的数据永远不会被判成「不存在」(没有假阴性),只会把没插入的误判成「可能存在」。所以它适合放在数据库前面当一层挡板:说不存在就直接返回,说可能存在再去数据库核实。
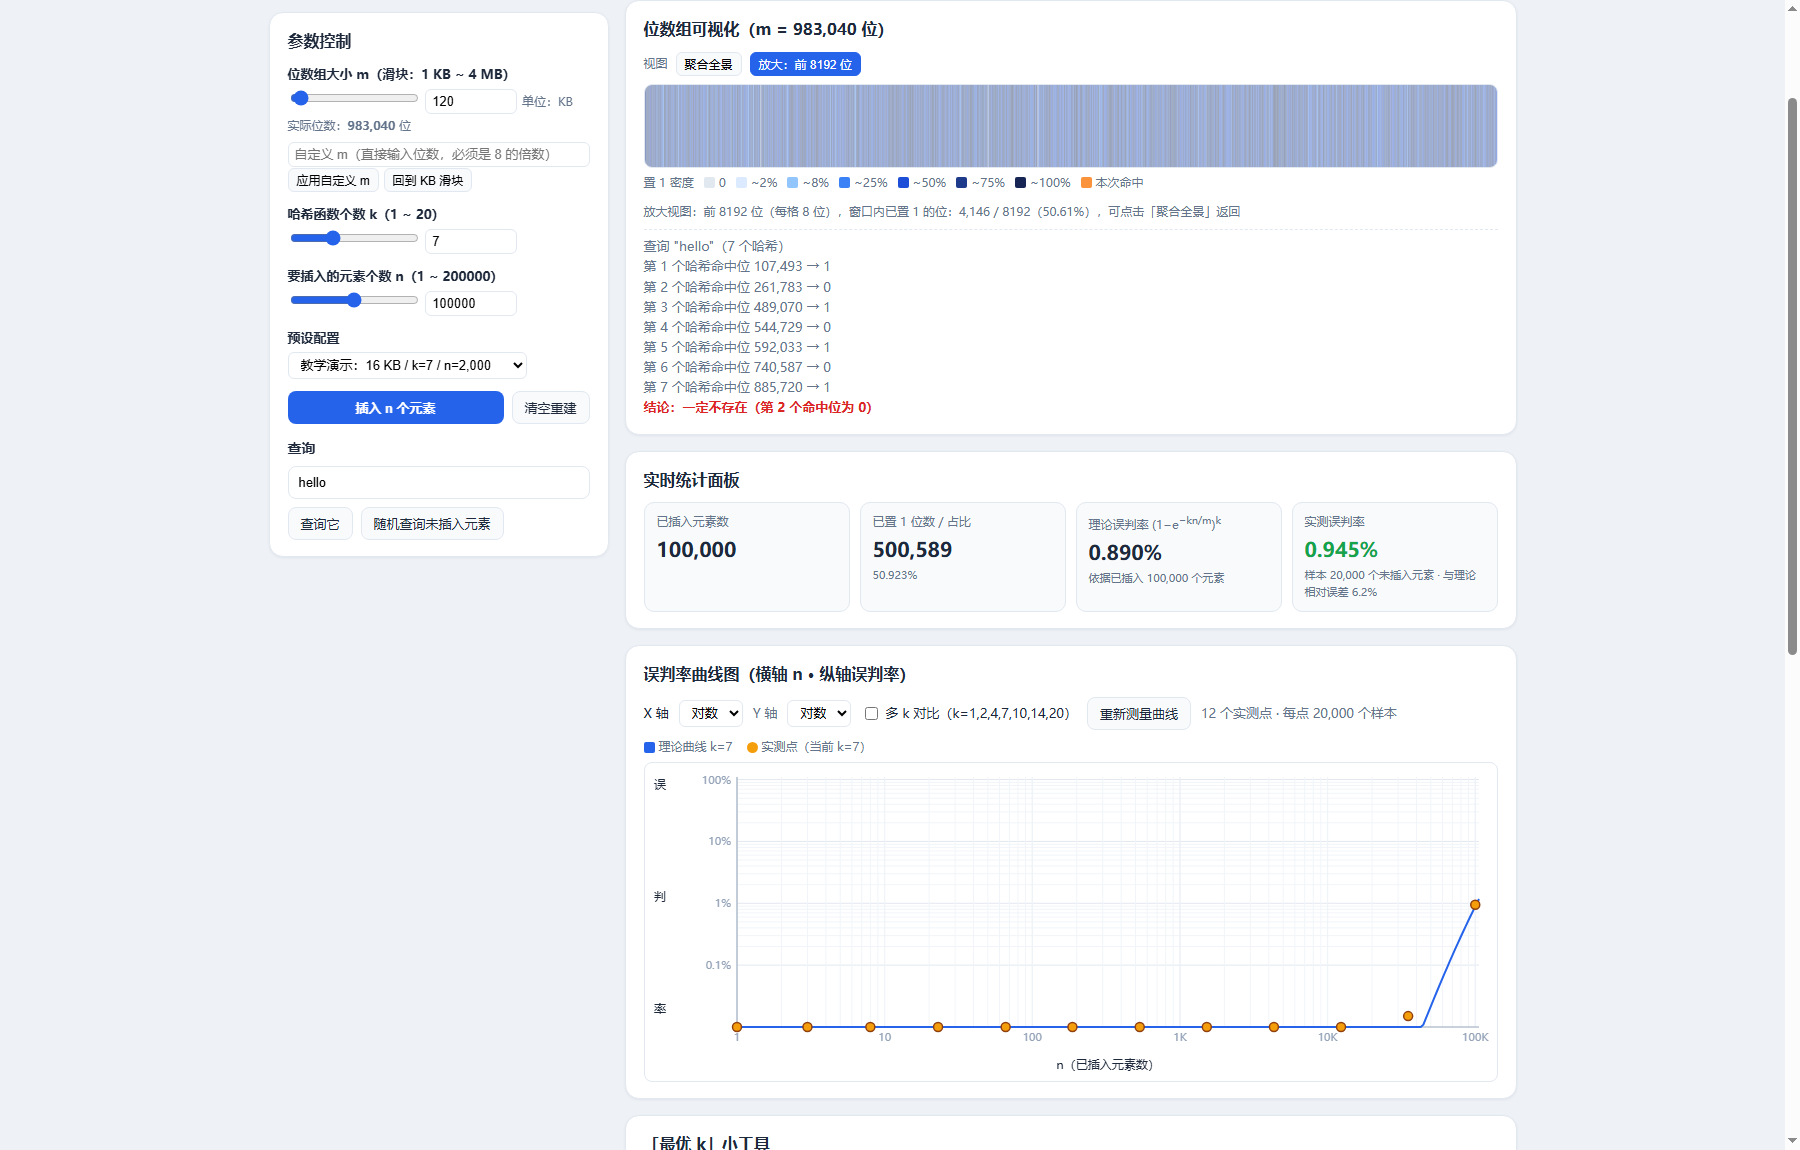
上图是查询一条确定没插入过的字符串「hello」:7 个哈希位置逐个给出「0 还是 1」,第 2 个位置是 0,页面直接判定「一定不存在」。插入数据时则是把这 7 位置 1、橙色标注。
同一张图里还能对上一个数:放大视图只看前 8192 位,其中 4,146 位是 1(50.61%),和全景统计的 50.923% 基本吻合——这是检查可视化有没有画错的最快办法,两边对不上就说明聚合或计数有问题。
三、实测:120KB / k=7 / 10 万条的误判率是 0.945%
把位数组设成 120KB(983,040 位)、k=7、插入 10 万条,页面给出的实测结果:
| 指标 | 数值 |
|---|---|
| 位数组大小 | 983,040 位(120KB) |
| 已置 1 的位数 / 占比 | 500,589 / 50.923% |
| 理论误判率 (1−e^(−kn/m))^k | 0.890% |
| 实测误判率(20,000 个未插入样本) | 0.945% |
| 实测与理论的相对误差 | 6.2% |
「实测」不是估的:页面用固定种子的伪随机数生成 20,000 条确定没插入过的字符串,逐条查询,统计被判成「可能存在」的比例。同一组参数重复跑,结果完全一致——这是可复现的前提。
6.2% 的偏差来自两点:理论公式假设 k 个哈希完全独立且均匀,实际哈希做不到;另外 20,000 次采样本身也有统计波动(0.945% 对应约 189 次命中,采样标准差约 7%)。所以别把 0.945% 当精确值,它和 0.890% 是同一档。
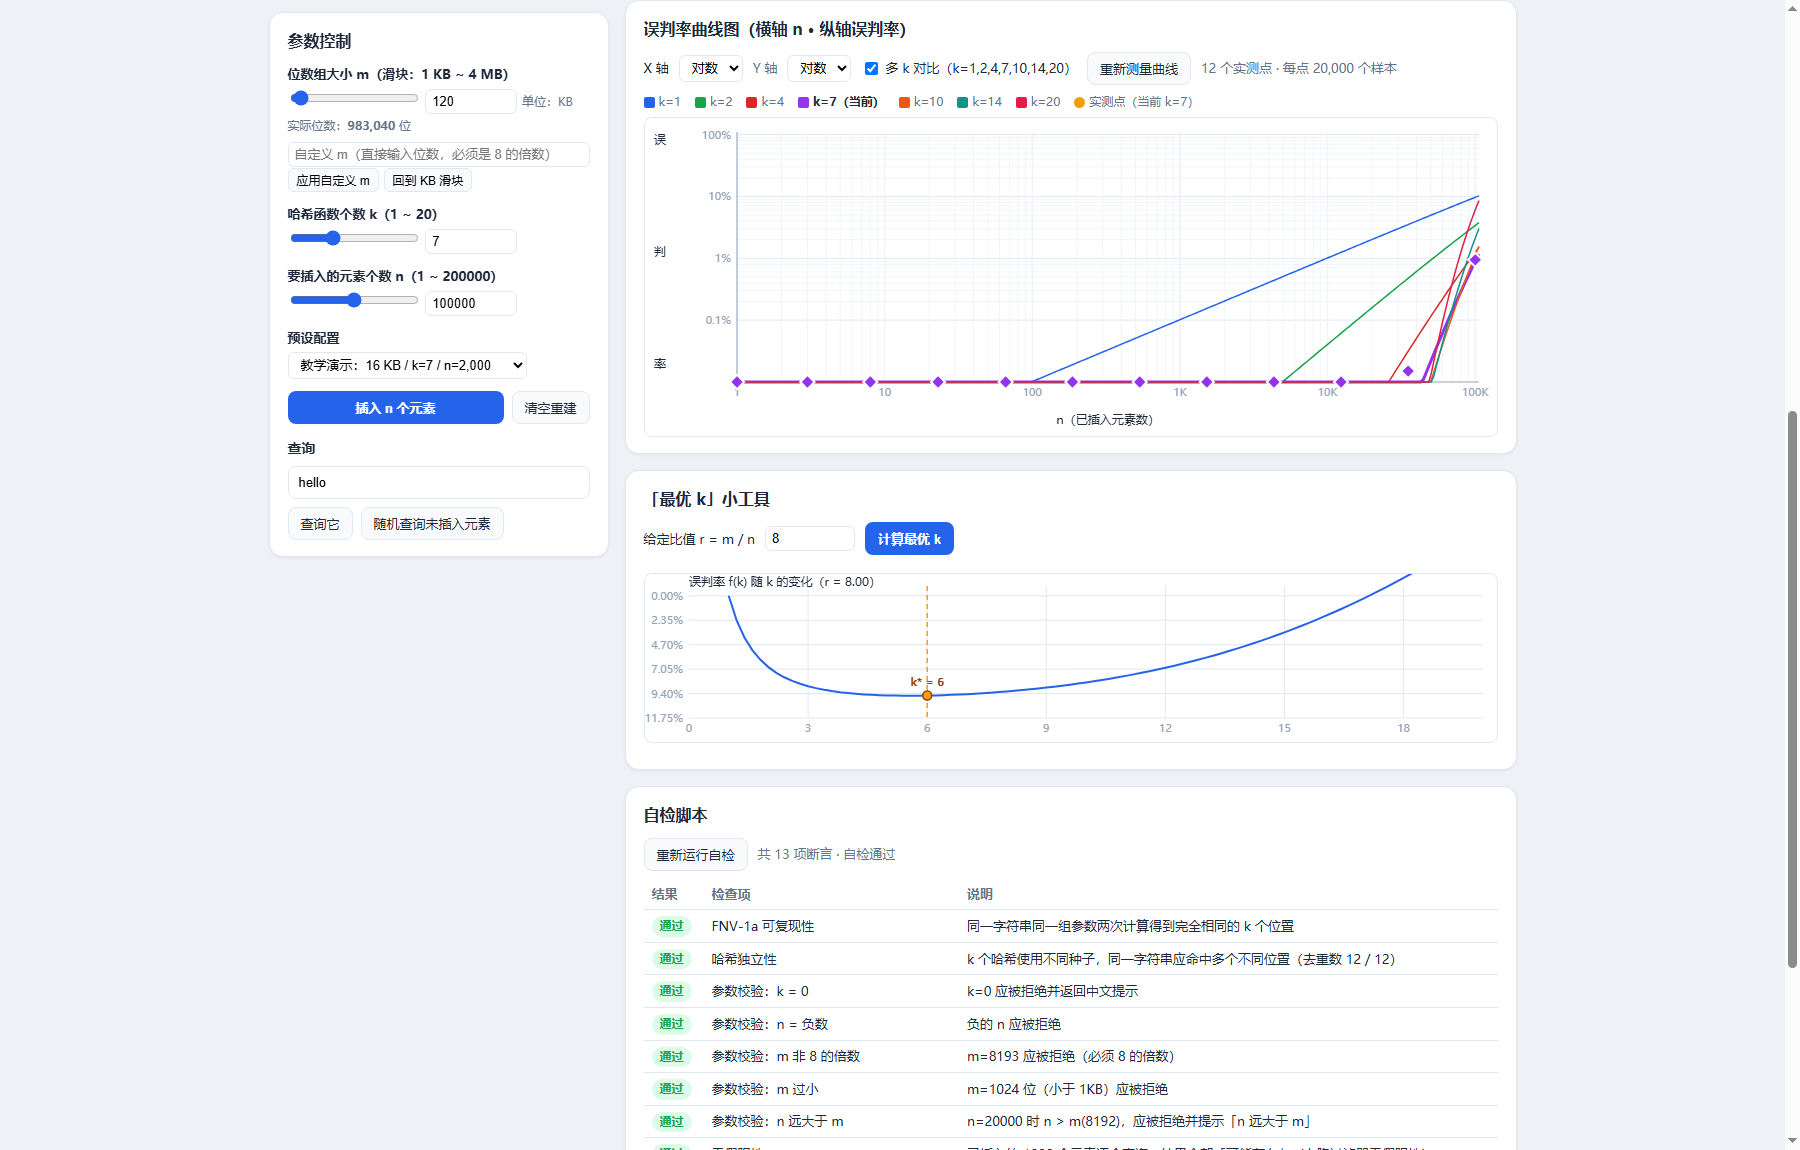
把 n 从 1 拉到 10 万,曲线是这个形状:前 1 万条几乎贴着 0(理论上 n=10,000 时只有 7.2×10⁻⁹),最后 10 倍区间才陡然抬头。这解释了为什么「按峰值容量算内存」比「按当前数据量算」重要——容量的账要按一年后的数据量算,但内存早就该按那个数开好。
四、k 不是越大越好:同一块 120KB,k 从 1 调到 20
这是这篇最想让你记住的一张表。位数组固定 120KB、n 固定 10 万,只改 k:
| k | 已置 1 位占比 | 理论误判率 | 实测误判率(20,000 样本) |
|---|---|---|---|
| 1 | 9.668% | 9.672% | 9.660% |
| 2 | 18.387% | 3.389% | 3.300% |
| 4 | 33.403% | 1.249% | 1.225% |
| 7 | 50.923% | 0.890% | 0.945% |
| 10 | 63.832% | 1.125% | 1.150% |
| 14 | 75.886% | 2.117% | 2.025% |
| 20 | 86.930% | 6.067% | 5.675% |
从 k=1 加到 k=7,误判率从 9.660% 一路降到 0.945%;k 继续加到 20,误判率反而回升到 5.675%——比 k=1 只好了不到一倍。所以「多挂几个哈希函数更保险」是个错觉,k 过了最优点就是负收益。
原因不复杂,看第二列就懂了:
- k 越大,插入一条数据就要置 k 个位,位数组越快被填满。k=20 时 86.9% 的位已经是 1。
- 查询要求 k 位全为 1 才判「可能存在」。k 变大确实提高了门槛,可位数组同时被自己填得更满。
- 两个效应相乘:门槛的收益按 k 的指数涨,饱和的代价也按 k 的指数涨,前者先占上风、之后被后者反超,最优解正好落在
k* = (m/n)·ln2。
120KB / 10 万条时 m/n = 9.83,算出来 k* = 6.8,取整就是 7——和实测的最低点一致。这也是速查表里 k 一列的来源。
五、内存也不是越大越好:120KB 和 1MB 差在哪
反过来把 k 固定在最优值、只改内存,对比更明显:
| 位数组 | 已置 1 位占比 | 理论误判率 | 20,000 次查询的实测 |
|---|---|---|---|
| 60 KB(491,520 位),k=3 | 45.680% | 9.534% | 9.825% |
| 120 KB(983,040 位),k=7 | 50.923% | 0.890% | 0.945% |
| 1 MB(8,388,608 位),k=7 | 8.004% | 2.11×10⁻⁶% | 0 次命中 |
从 60KB 加到 120KB,误判率从 9.825% 掉到 0.945%,内存只多花 60KB,这是全场性价比最高的一档。再往上加到 1MB:理论误判率 2.11×10⁻⁶%(大约 4700 万次查询才误判一次),20,000 次采样一次都没命中。
页面对这种情况的处理值得一提:它没有直接报「误判率 0%」,而是标注「低于采样分辨率,实测与理论不可分辨」。20,000 次采样能分辨的下限大约是 0.005%,比这更小的误判率,采样再多次也测不出来——想知道真实值只能算,不能测。这一点在做性能测试时同样成立:样本量决定了你能断言的最小差异。
六、准备环境与实操:进入码道 Web,从一句话需求到 13 项自检
这个页面是用码道做的。码道有三种使用方式:WebUI(浏览器对话)、TUI(终端命令行)和桌面 IDE(IDE 插件)。本文用的是 WebUI 版。
浏览器打开码道 Web 版:https://devcloud.cn-north-4.huaweicloud.com/chat?source=dmzntgwsf&sourcead=dmzntgwwbwz,登录后就能在对话窗口输入需求,不需要装软件。
我把需求写成了 11 条验收点,核心是这几句:
- 单文件
index.html,原生 JS,不引入任何外部库、不联网 - 位数组可视化成方格,插入时点亮命中的位,查询时逐个展示 k 个位置是 0 还是 1
- m(1KB~4MB)、k(1~20)、n(1~200000)可调
- 实测误判率用固定种子的伪随机样本统计,并和理论公式 (1−e^(−kn/m))^k 并排显示
- 画误判率曲线,给出「最优 k」小工具,内置 4 组以上预设
- 失败路径全部要有中文提示且不能崩
- 页面里要有自检脚本,把自检结果显示出来
最后一句是这次最值钱的地方:要求它把自检渲染在页面上。交付时页面里有 13 项断言,全部通过,其中包括一条「实测误判率与理论值相对误差 < 15%」的硬断言(自检自己跑的那组是 m=8192、k=7、n=2000、样本 30,000:实测 25.447% vs 理论 24.706%)。
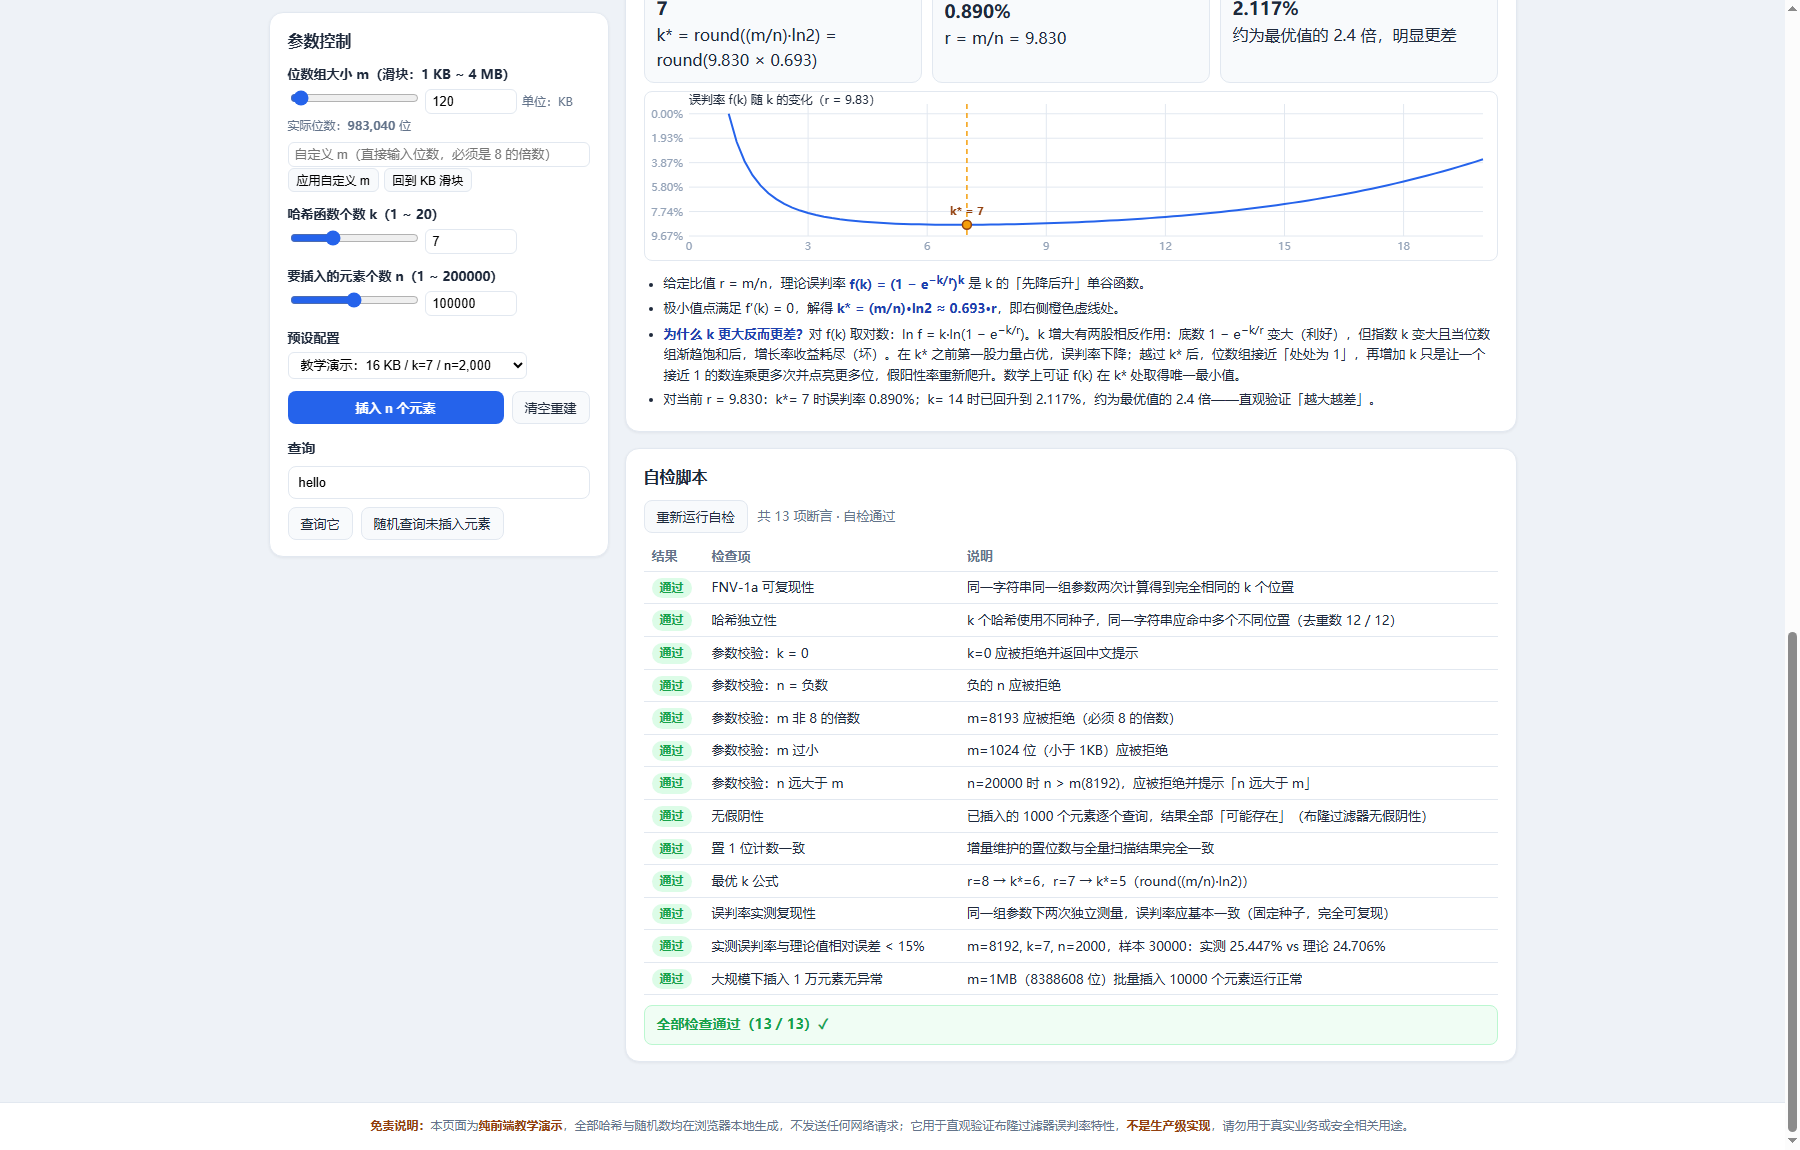
13 项里我挑几条能说明它没在敷衍:FNV-1a 可复现性(同参数两次计算位置完全一致)、哈希独立性(同一字符串的 k 个位置去重后仍有 12/12 个不同位置)、无假阴性(已插入的 1,000 个元素逐个查询全部判定「可能存在」)、增量维护的置 1 位数与全量扫描结果一致。这些断言都是「跑给别人看」的,不是「声明自己写完了」。
交付物就是一个单文件 index.html(本地 58 KB),源码里没有 fetch、没有 XMLHttpRequest、没有任何外部 URL,零依赖、零网络请求,直接双击就能打开。
七、验证与踩坑:四个真实问题,以及怎么自己复现
第一版交付后我逐张看了截图,发现三个问题,又让它改了一轮:
- 曲线图的坐标轴标题压在图里。Y 轴「误判率」是竖排文字,和刻度数字叠在一起;X 轴标题也压着刻度。这不是功能 bug,但截图放进文章就是明显的瑕疵。
- 只画了「当前 k」一条曲线,看不出「k 越大越差」这个结论。第二版改成同时画 k = 1、2、4、7、10、14、20 七条理论曲线并叠加实测点,上面那张曲线图就是这么来的。
- 位数组在 m 很大时是一整片同色方块。983,040 位按 820 位一段聚合,段内 50% 左右的置 1 密度全都落在同一个颜色档,看不出结构。第二版把密度色阶拉开才好辨认。
改完第二轮又抓到一个更细的问题:放大视图的说明文字里多了一个写死的「1」,渲染出来是「窗口内置 1 4,146 / 8192」。功能没错,但数字旁边的杂字会让人怀疑统计到底准不准,所以又提了一轮把它改成「窗口内已置 1 的位:4,146 / 8192(50.61%)」。这类问题只有把截图放大看才会发现。
另外两个边界值得记一下:
- 取回源码不能直接抓预览。码道 Web 的内置预览是一个 blob URL 的 iframe,
document里拿不到内容;真源码要走同源接口按路径取文件,别在 iframe 上折腾。 - 参数校验的提示写得很实在。n 超过位数组总位数时,页面的原话是:「n 远大于 m:要插入的元素个数(20000)超过了位数组的总位数(8192),每个 1 位平均要承载一个以上元素,位数组会完全饱和、误判率趋近 100%,已取消本次操作。请增大 m 或减小 n(提示:m/n 最好 ≥ 6,工程上常取 m/n ≈ 10~16)。」——把「为什么拒绝」和「改到哪个量级」一起说清楚了,这比「参数错误」四个字有用得多。
想自己复现,不需要装任何东西。
- 源码:Demo Park 公开仓库 → https://atomgit.com/deli007/demo_park/tree/main/codearts-bloom-filter-lab,
index.html可直接下载 - 本地运行:双击文件即可;或按下面两行起个静态服务
# 把 index.html 放到任意目录,起一个本地静态服务
python -m http.server 8000
# 浏览器打开 http://localhost:8000/index.html
打开后点「自检脚本」区域的「重新运行自检」,13 项断言会重新跑一遍;想看本文的数据,依次选「生产典型」预设(1MB / k=7 / 10 万条),再把 m 调成 120KB、k 依次改 1/2/4/7/10/14/20,每次点「插入 n 个元素」即可。整套跑下来不到三分钟。
八、用码道 Web 做这类小工具的三点体会
- 把「验收标准」写进需求,而不是写「你做完就行」。 11 条需求里真正起作用的是第 10 条(自检渲染到页面上)和第 8 条(失败路径要有中文提示)。这两条逼着它把边界情况跑一遍,而不是只交一个能跑通的正常路径。
- 要求它自证,而不是自己声明。 「自检 13/13 通过」和「功能已实现」是两种东西。前者我可以点一下按钮复核,后者我只能选择信或不信。
- 第一版一定会有看起来没问题、但截图一放大就露馅的细节。 坐标轴压字、色阶不够、图例遮挡,这些都不影响功能,但影响它能不能被贴进文章。所以交付后要逐张看图,再提一轮具体的修改点——「第 1 张图 Y 轴文字压住刻度」比「再优化一下界面」有效一百倍。
九、总结
回到标题:120KB 装 10 万条 URL,k 开到 20 反而更差。三个可以直接拿去用的数:
- 内存按目标误判率反推:1% 误判率 → 每条 9.6 位;0.1% → 每条 14.4 位;10 万条就是 120KB 和 176KB。
- k 取
round((m/n)·ln2):120KB / 10 万条是 7。实测 k=1 时 9.66%、k=7 时 0.95%、k=20 时 5.68%,两头都更差。 - 采样量决定你能断言什么:20,000 次采样只能分辨到 0.005% 左右,比这更小的理论误判率,测出来的只会是 0。
布隆过滤器不复杂,麻烦的从来是「参数怎么定」。把参数、实测、理论公式摆在同一屏上,对着曲线调两次,比背公式快得多。
想自己动手:源码在 Demo Park 公开仓库的 codearts-bloom-filter-lab 下,index.html 双击就能打开,截图与需求原文在同一目录;参数扫描按上一节的步骤跑,不到三分钟。
本文用到的页面由码道生成,源码为单个 index.html,可离线打开;文中所有误判率均为页面实测输出,理论值与独立复算结果一致。

- 点赞
- 收藏
- 关注作者
评论(0)